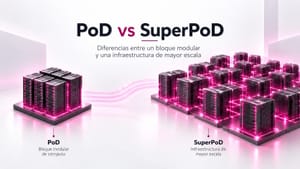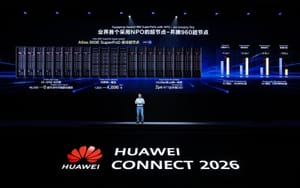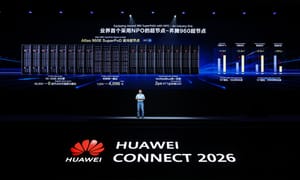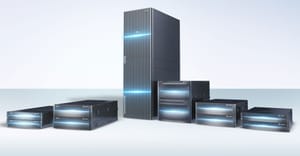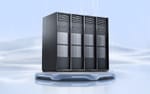
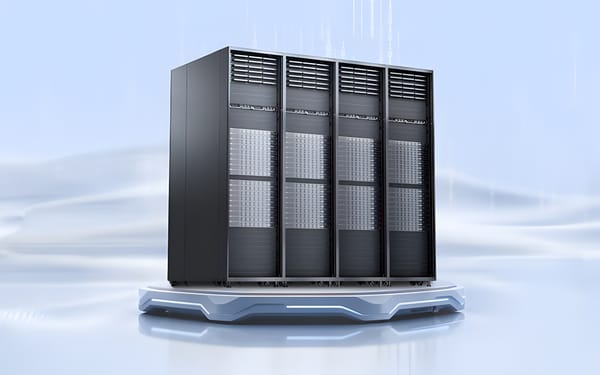
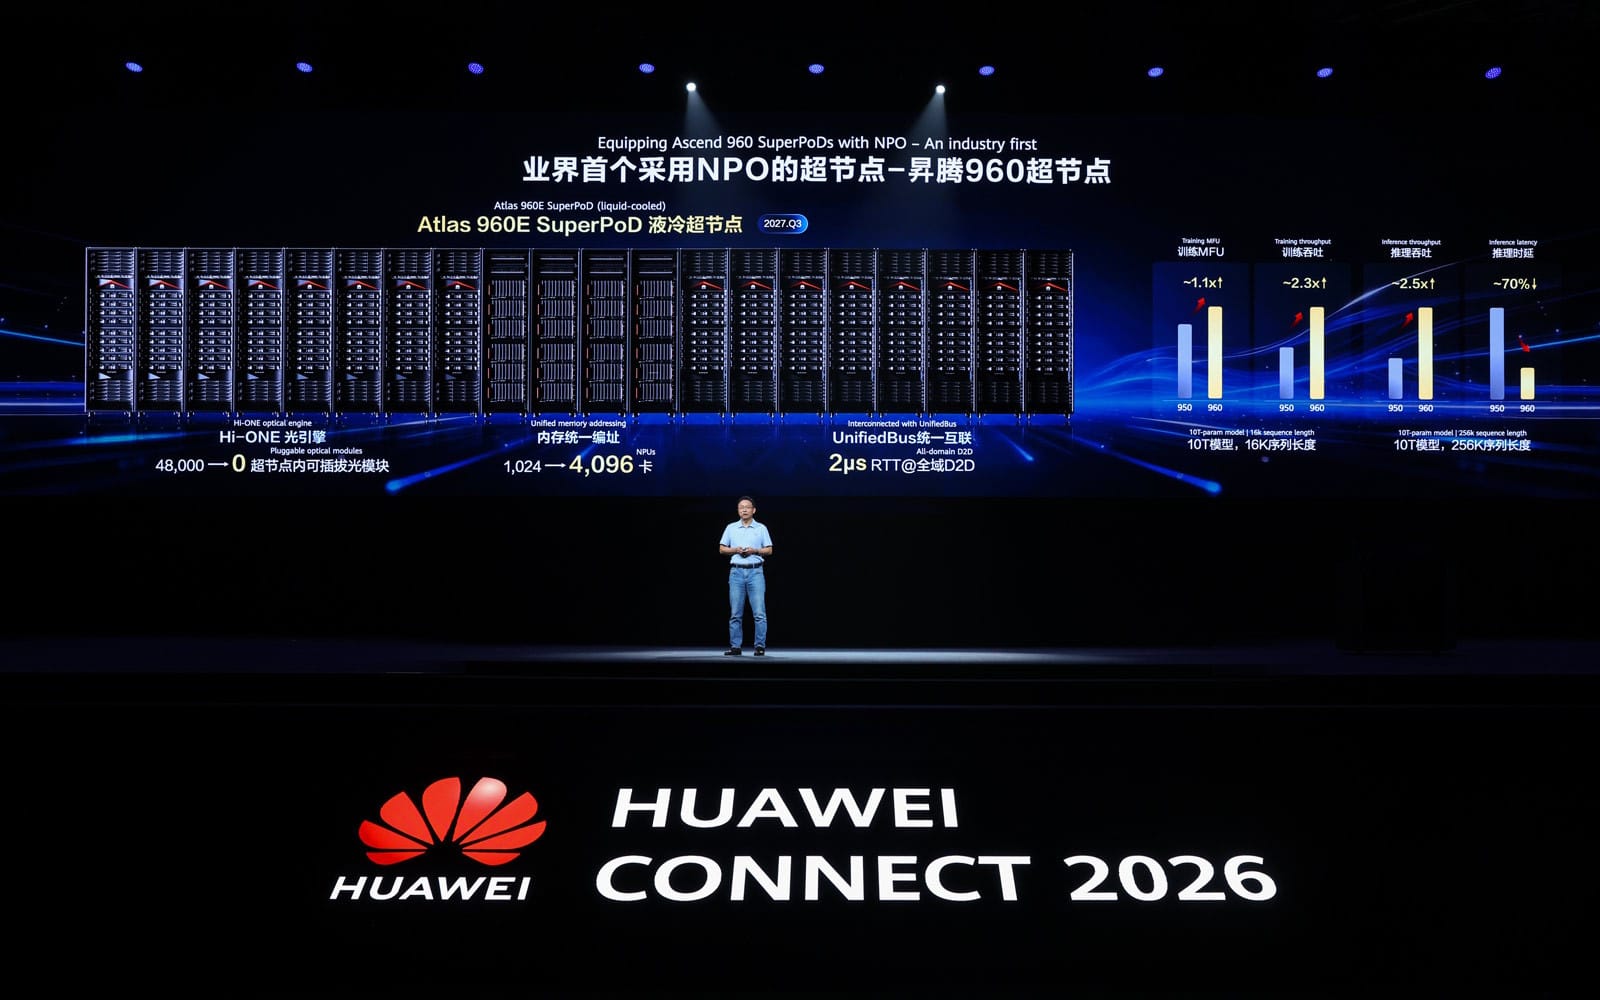
Huawei presentó OceanStor M900 Context Memory Storage durante HUAWEI CONNECT 2026, un sistema orientado a la inferencia de Inteligencia Artificial en centros de datos de hiperescala y diseñado para trabajar con SuperPoD. La arquitectura distribuye el KV cache entre memoria integrada en los procesadores, DRAM y SSD, con el objetivo de ampliar la capacidad disponible para modelos con contextos extensos y tareas de múltiples turnos.
 Francisco Carrasco M.
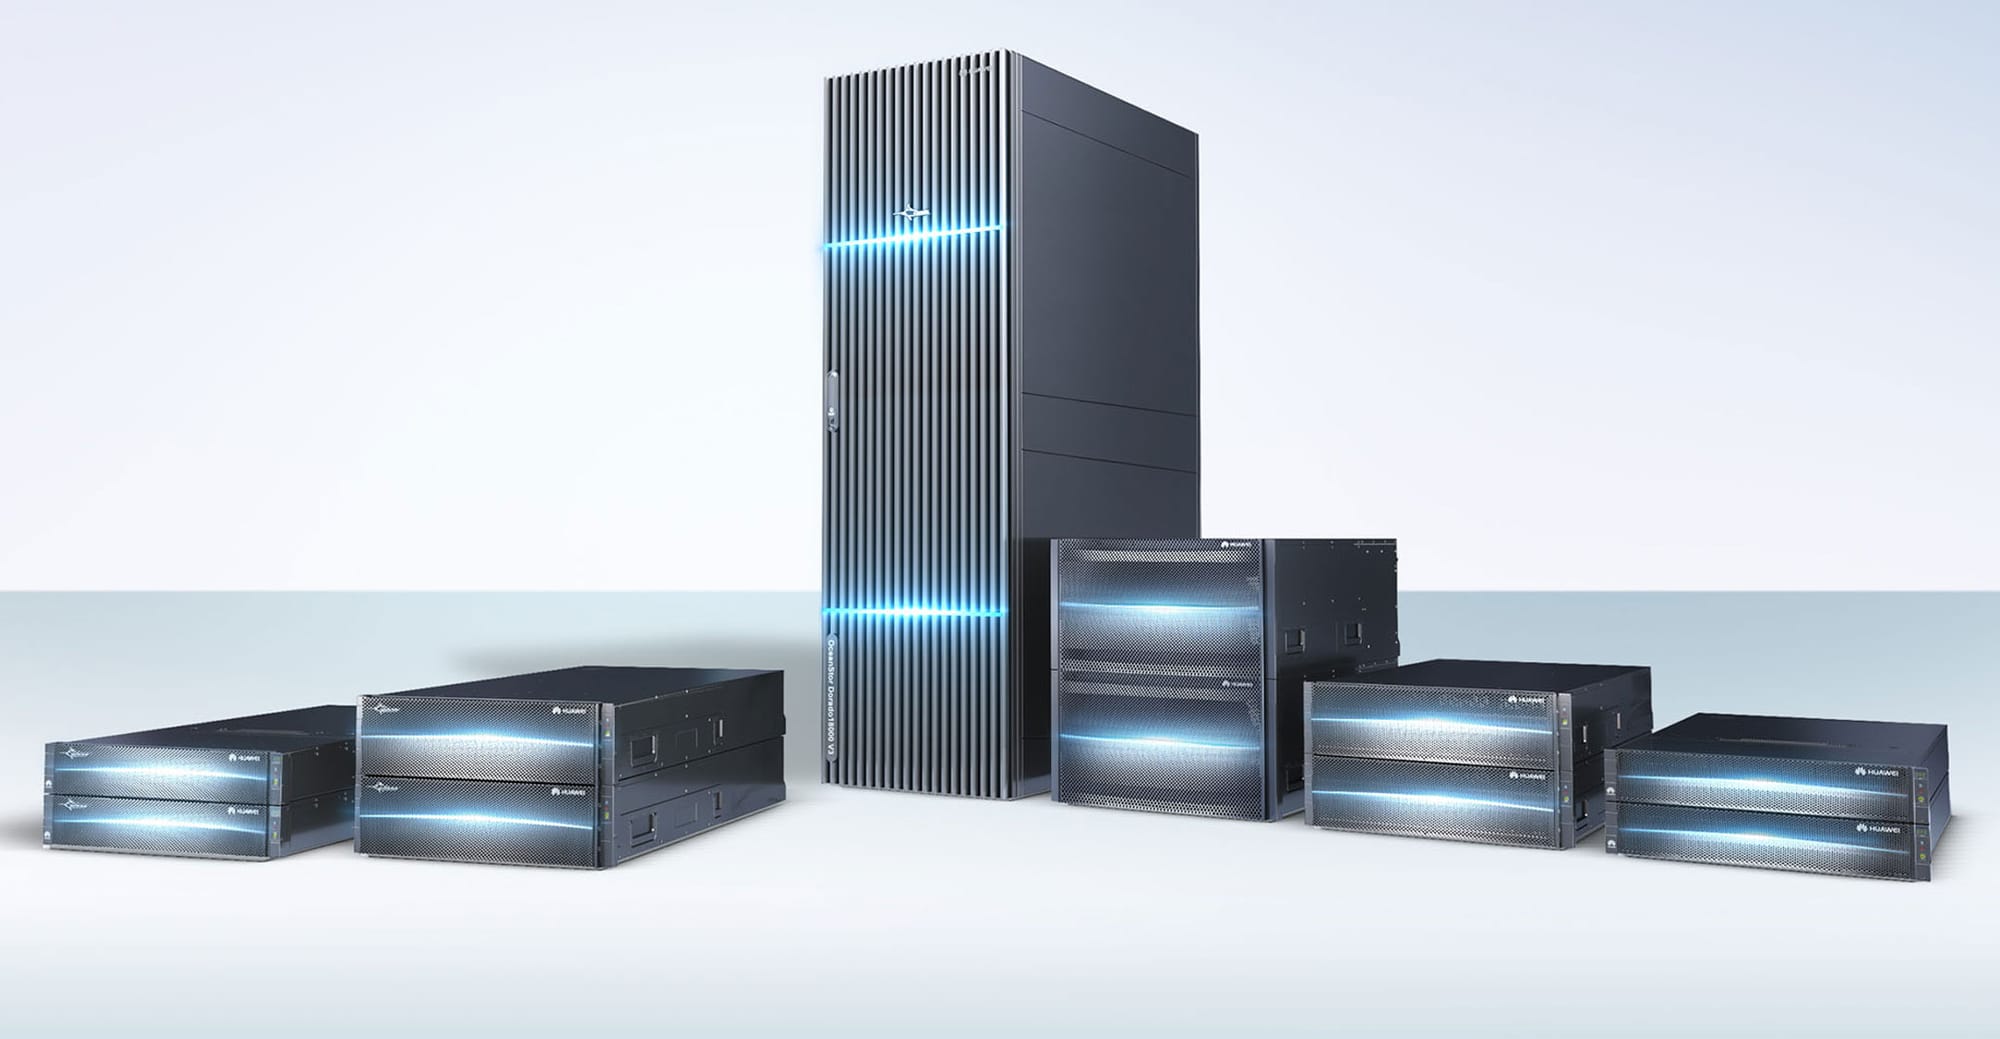
¿Cómo amplía OceanStor M900 el KV cache de los SuperPoD?
El KV cache almacena los datos Key y Value generados durante la inferencia para reutilizarlos posteriormente y evitar cálculos redundantes. Huawei relaciona el crecimiento de estos datos con modelos de gran tamaño, ventanas de contexto superiores al millón de tokens y cargas donde las interacciones se prolongan durante múltiples turnos.
OceanStor M900 utiliza la red UnifiedBus para crear un pool global de KV cache y aplicar almacenamiento por niveles entre la memoria integrada, DRAM y SSD. Según Huawei, un único clúster puede alcanzar 64 PB, mientras que la capacidad disponible de KV cache por NPU pasa desde una escala de gigabytes a terabytes.
 Francisco Carrasco M.
La compañía plantea este diseño como una alternativa a mantener todo el KV cache en memorias de mayor costo y capacidad limitada. Los datos almacenados pueden compartirse y reutilizarse dentro del SuperPoD, con el propósito de incrementar la proporción de solicitudes que encuentran información disponible en el cache.
¿Qué cambia en latencia, ancho de banda y vida útil de los SSD?
OceanStor M900 integra CPU, unidad controladora de red y unidad controladora NAND dentro de su arquitectura, además de incorporar semántica nativa para KV cache. Este diseño establece una conexión de un salto entre las NPU del SuperPoD y los SSD, evitando el reenvío mediante CPU y conversiones adicionales de protocolo.
 Admin
Huawei afirma que esta arquitectura reduce la latencia de acceso desde milisegundos hasta 60 microsegundos, lo que representa una disminución del 90%, mientras un clúster alcanza 40 TB/s de ancho de banda agregado. La compañía también señala que esta última cifra es 1,5 veces superior a soluciones comparables, aunque la publicación no entrega la configuración ni metodología utilizada para esa comparación.
En escenarios que Huawei describe como típicos de programación con IA, la empresa reporta que el sistema duplica el rendimiento de tokens del clúster de inferencia y reduce a la mitad el tiempo hasta el primer token o TTFT. La publicación tampoco especifica los modelos, cargas de trabajo ni configuración de hardware empleados para obtener estos resultados.
 Admin
El sistema incorpora además una tecnología de almacenamiento adaptativo consciente del KV cache, que distribuye los datos entre distintos medios según la vida útil estimada de cada bloque de información. Huawei indica que esta gestión permite alcanzar hasta 24 escrituras completas de unidad por día o DWPD, extender 16 veces la resistencia de los SSD y mantener esa operación durante tres años.