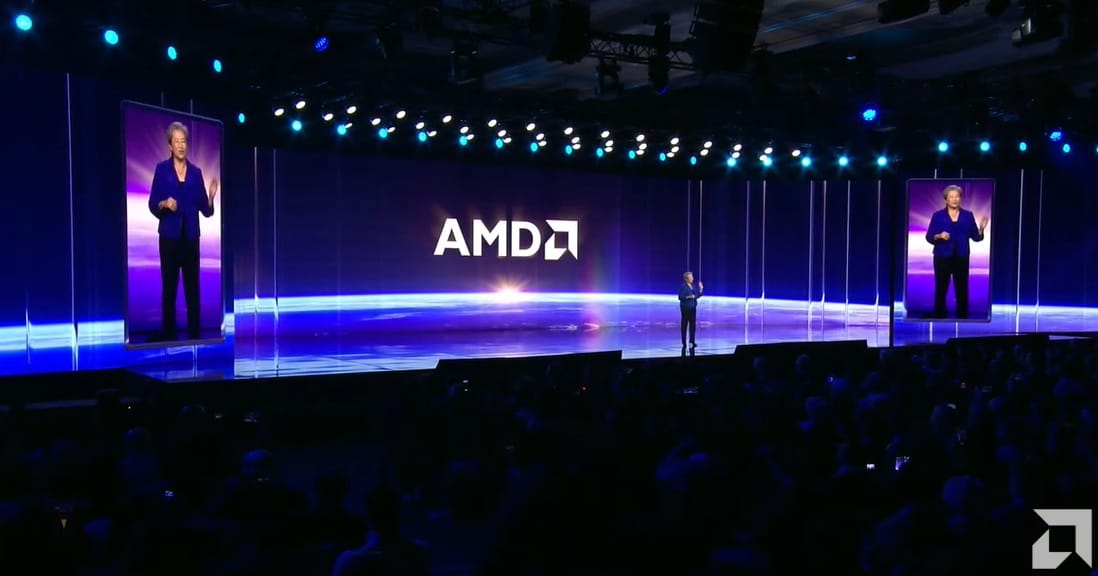
AMD y Unsloth habilitaron la ejecución local de modelos de inteligencia artificial sobre las unidades de procesamiento neuronal XDNA 2 de equipos Ryzen AI compatibles, con acceso desde más de 100 aplicaciones y flujos de trabajo de IA agéntica.
La integración utiliza Unsloth Desktop para derivar las solicitudes de los agentes hacia la NPU, mientras el procesador central y la GPU continúan disponibles para otras funciones del sistema. La compatibilidad se limita a modelos y equipos admitidos.
La colaboración, anunciada el 19 de noviembre de 2026, incorpora por primera vez el soporte de NPU a Unsloth Desktop. Esta aplicación de código abierto permite ejecutar y ajustar modelos localmente, sin depender exclusivamente del procesamiento mediante CPU o GPU.
 Columnas al director
Una API compatible con OpenAI conecta las herramientas de IA agéntica
El mecanismo se basa en una interfaz de programación compatible con la API de OpenAI. Las aplicaciones envían solicitudes a Unsloth Desktop y los componentes Lemonade y FastFlowLM gestionan el servicio del modelo y la inferencia en la NPU.
AMD menciona entre las herramientas compatibles a Hermes Agent, OpenClaw, Open WebUI, Cline, LangChain y GitHub Copilot. Esto no supone que todas sus funciones se ejecuten en la NPU, sino que pueden solicitar inferencia a un modelo local compatible.
Las NPU admitidas pertenecen a la arquitectura AMD XDNA 2. Según la documentación de Unsloth, los equipos compatibles incluyen las familias Ryzen AI 300, Ryzen AI Max y Ryzen AI 400, con soporte para Windows 11 y Linux en sistemas x64.
 Francisco Carrasco M.
El consumo energético y la memoria condicionan la ejecución local
El objetivo técnico es trasladar a un acelerador dedicado las consultas de modelos compatibles que permanecen activos durante sesiones prolongadas. La propuesta busca reducir el consumo asociado a esas tareas y reservar recursos para aplicaciones que funcionan simultáneamente.
 Francisco Carrasco M.
En un artículo técnico complementario publicado por AMD, Syed Muhammad Usman Pirzada, gerente de marketing de producto para inteligencia artificial en dispositivos cliente de la compañía, explicó el ahorro energético potencial y señaló que la disponibilidad de recursos también depende de la memoria del equipo.
“Las NPU AMD XDNA 2 están diseñadas para una inferencia de IA eficiente [...]. Transferir las cargas de trabajo de inferencia compatibles a este motor dedicado puede ayudar a preservar la duración de la batería y dejar disponibles recursos de CPU y GPU [...] (siempre que la memoria lo permita)”.
AMD ejemplifica la restricción con Qwen3.6-35B-A3B, que necesita aproximadamente 28 GB disponibles para la NPU con contexto completo. Con la asignación compartida predeterminada de Windows, la compañía indica que el equipo requiere 64 GB de RAM.
Por ello, el alcance de la integración depende tanto del procesador como del modelo elegido y la memoria instalada. La documentación de Unsloth precisa que la inferencia mediante NPU emplea modelos Q4NX adaptados a FastFlowLM, no cualquier archivo GGUF directamente.
Unsloth permite activar la NPU desde su selector de modelos y descargar una variante compatible, aunque algunos sistemas pueden requerir actualizar controladores o firmware. La compatibilidad de las aplicaciones no equivale a que toda su carga computacional quede trasladada al acelerador.