Huawei presentó Peerium Computing Architecture, una arquitectura de cómputo diseñada para que hasta un millón de procesadores trabajen como un solo sistema. La propuesta busca responder al crecimiento de la demanda de capacidad de cómputo para inteligencia artificial.
 Admin
Peerium combina paralelismo anidado y direccionamiento unificado de memoria
Peerium escala hasta el nivel de un millón de procesadores mediante paralelismo anidado, direccionamiento unificado de memoria e interconexión entre pares. La arquitectura introduce Nested BSP —Nested Bulk Synchronous Parallel—, extiende el modelo de máquina única de von Neumann y reemplaza la estructura maestro-esclavo por un esquema que permite operar los procesadores como un sistema de mayor escala.
UnifiedBus (UB) es la tecnología de interconexión utilizada por Peerium y está construida sobre un único protocolo abierto. El bus conecta CPU, NPU, memoria, SSD, tarjetas de interfaz de red y switches, además de habilitar la interconexión entre pares a través de cómputo, almacenamiento y redes.
Atlas 950 es la primera generación de productos basada en Peerium
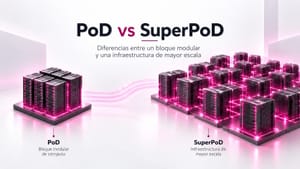
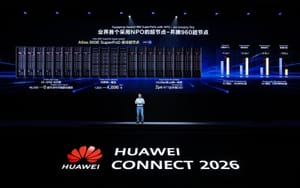
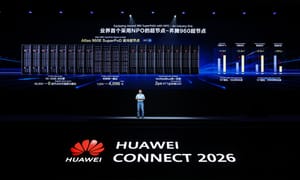
Huawei confirmó que Atlas 950 SuperPoD y los SuperClusters basados en SuperPoD constituyen la primera generación de productos construida sobre Peerium Computing Architecture. Un Atlas 950 SuperCluster equipado con 256.000 tarjetas ya se encuentra en despliegue.
 Admin
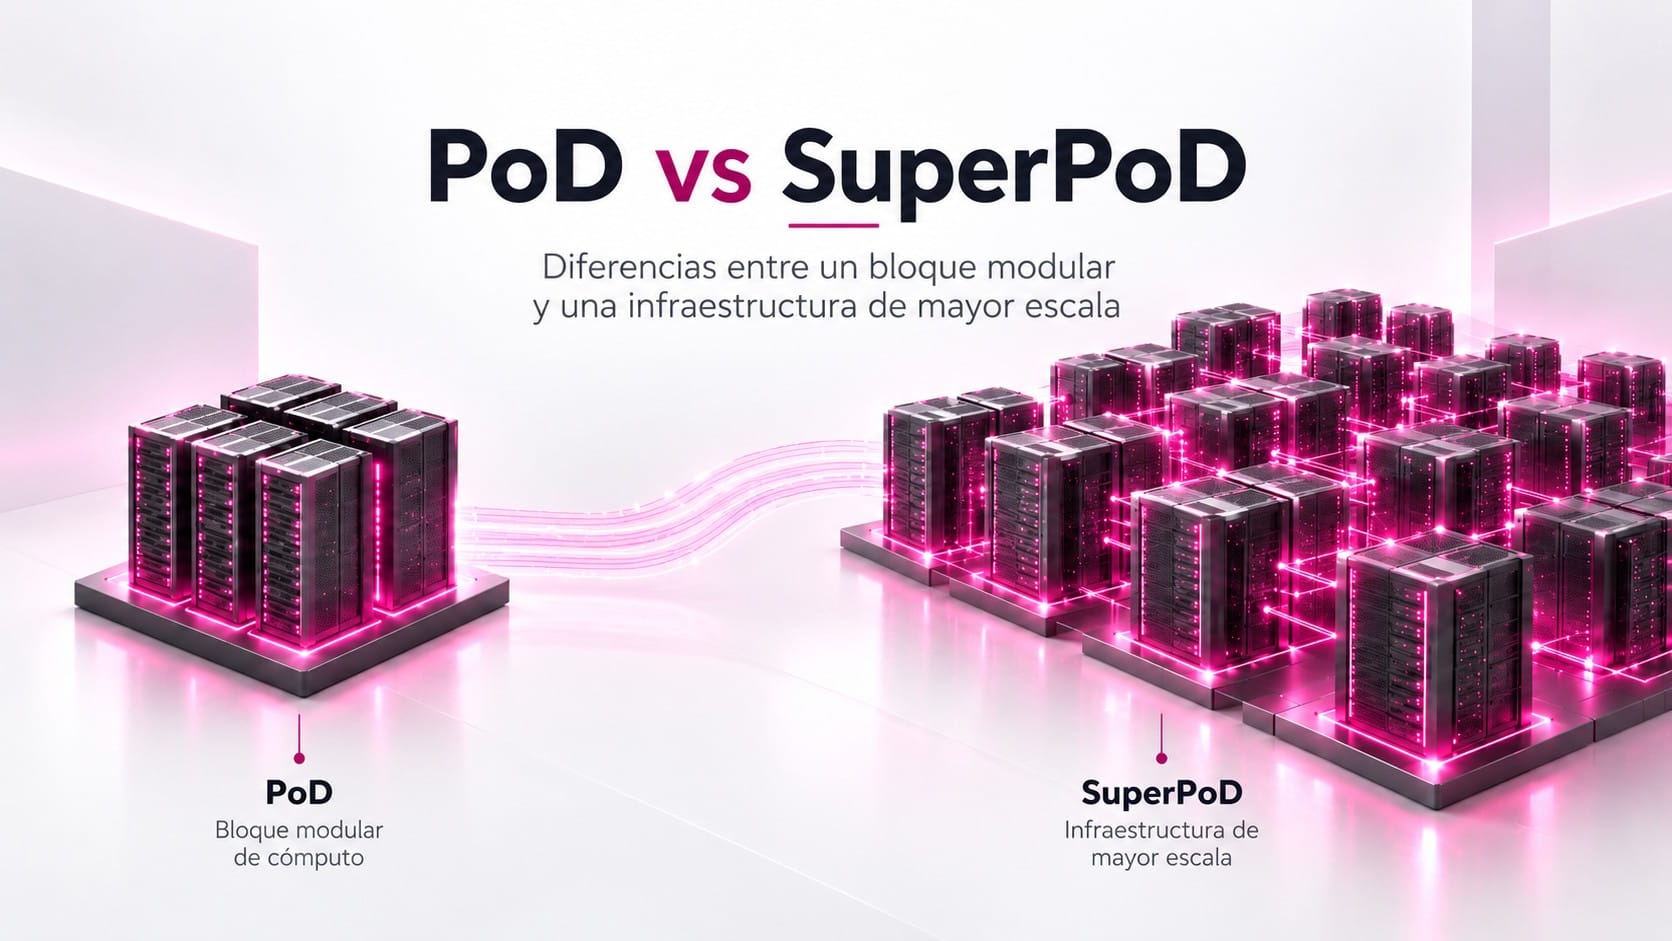
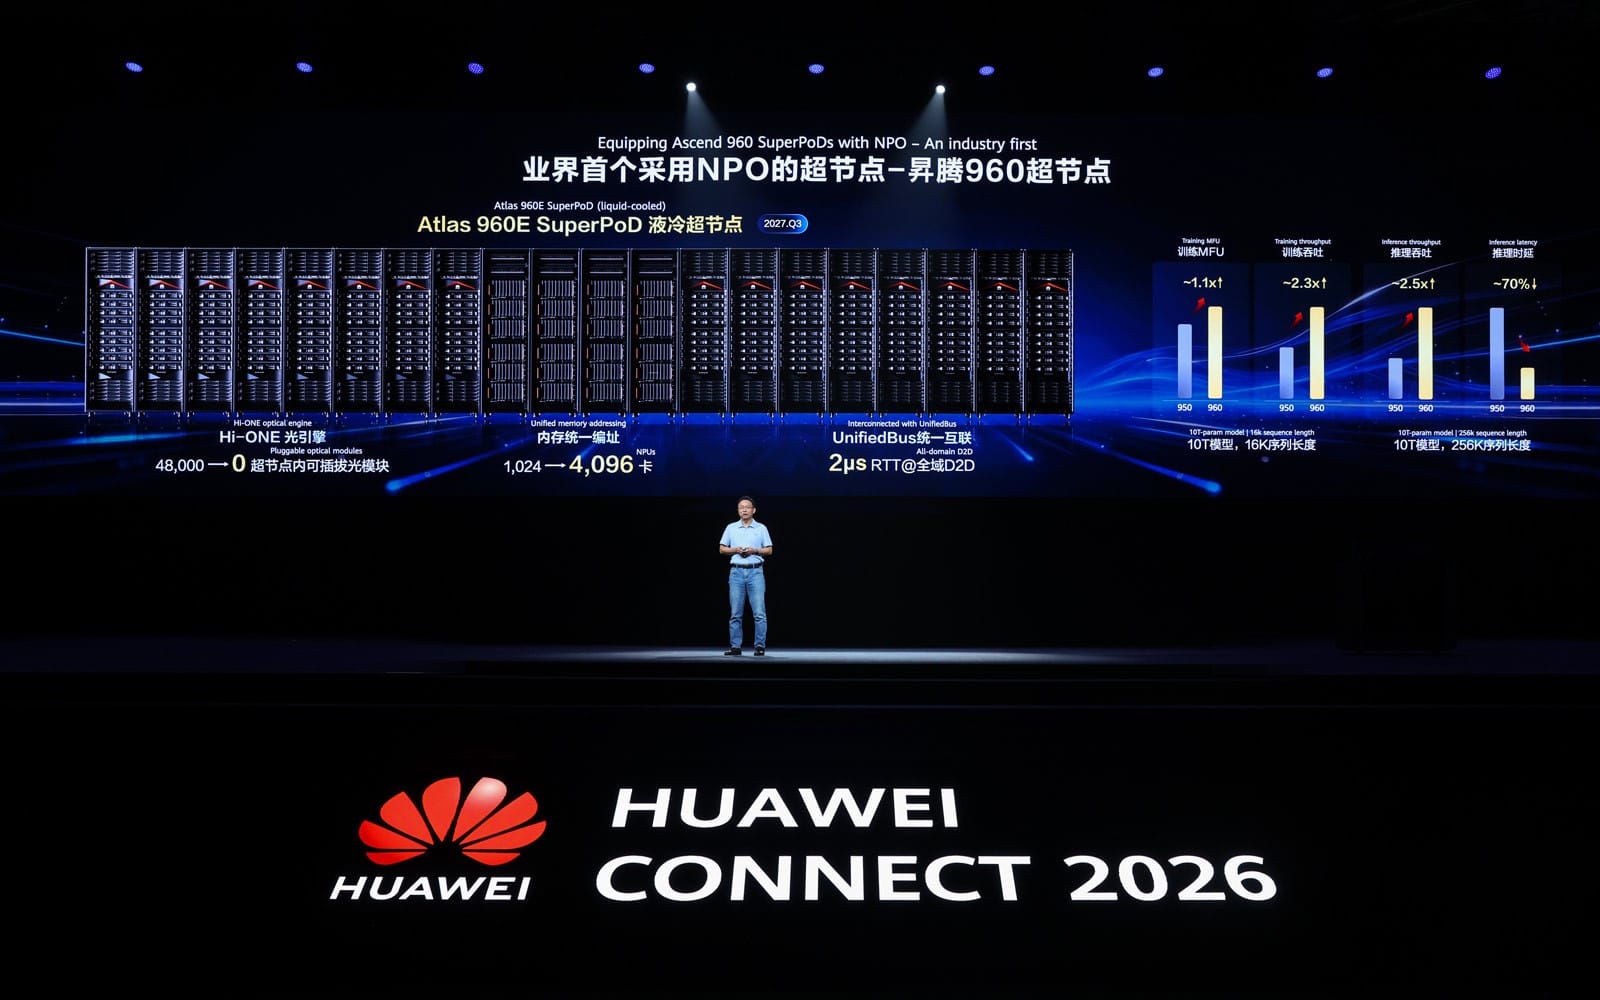
La compañía también informó que el sistema Atlas 960, basado en near-packaged optics (NPO), se encuentra actualmente en pruebas.
Eric Xu, presidente rotativo de Huawei, explicó que la compañía está utilizando Peerium como base para desarrollar SuperPoD y SuperClusters destinados a cubrir las necesidades de entrenamiento e inferencia de sus clientes y ampliar la disponibilidad de capacidad de cómputo para IA.
“En la era de la IA, Huawei está aprovechando la arquitectura de computación Peerium que desarrollamos de manera pionera para construir continuamente los SuperPoD y SuperClusters basados en SuperPoD que satisfagan las necesidades de los clientes para entrenamiento e inferencia, haciendo que la potencia de cómputo esté disponible en todas partes y que la inteligencia sea accesible para todos”.