Intel presentó Inference Microservices, una solución que detecta el procesador del servidor y aplica una configuración validada para ejecutar modelos de lenguaje. La primera versión funciona sobre Xeon de cuarta, quinta y sexta generación y utiliza el motor vLLM.
Con este software, la compañía busca aprovechar la capacidad Xeon ya instalada y reducir los ajustes manuales de cada despliegue. Los modelos se ejecutan dentro de la infraestructura del cliente, donde también permanecen los datos.
 Admin
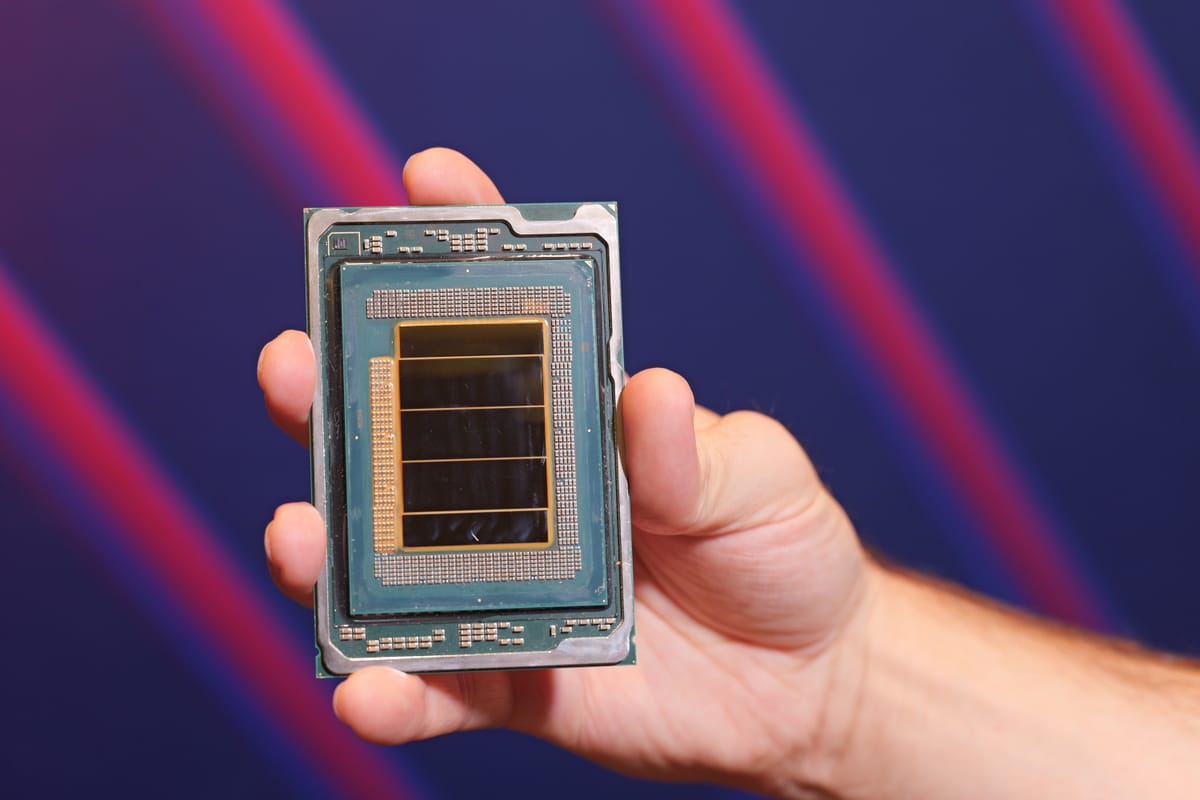
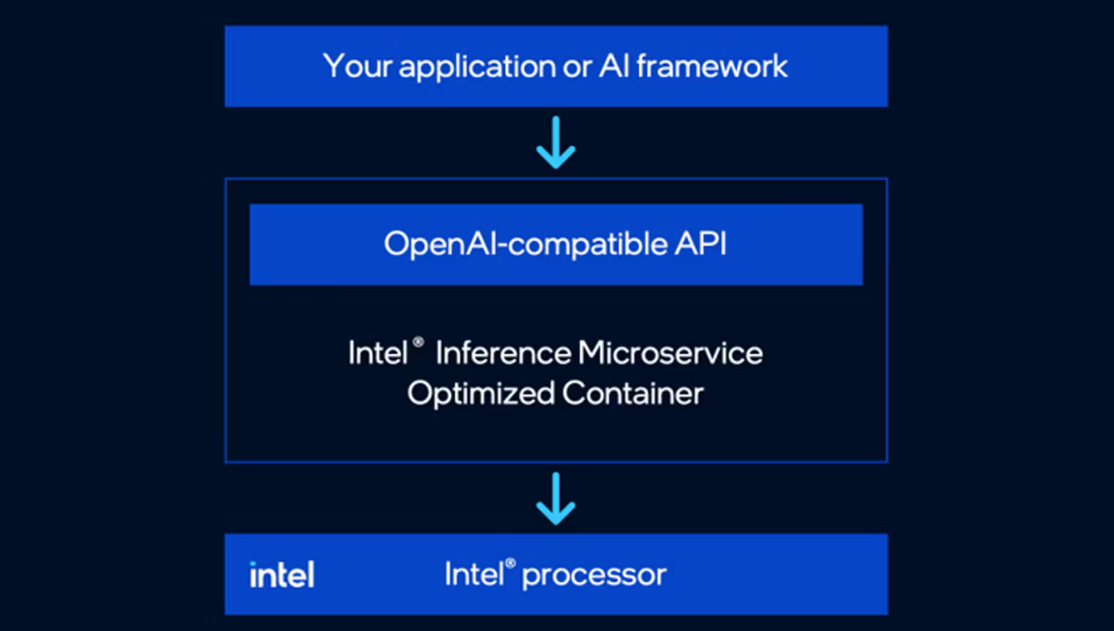
Cada contenedor atiende un modelo en un servidor y expone una API compatible con OpenAI. Para administrar múltiples instancias compartidas entre equipos, Intel propone complementarlo con AI for Enterprise Inference, que aporta funciones de seguridad y enrutamiento.
Perfiles ajustados al modelo y a los recursos disponibles
Durante el arranque, el contenedor identifica la generación del procesador, los núcleos asignados, los nodos NUMA y los aceleradores disponibles para elegir un perfil validado que fija la precisión, la distribución del trabajo y la organización de la memoria.
Los perfiles consideran aceleradores integrados como Intel AMX y las extensiones AVX-512, AVX2 y VNNI. Según Intel, cada imagen específica de un modelo incorpora la configuración con mejor rendimiento entre las que midió para ese procesador.
Las imágenes específicas detienen el arranque si no reconocen una configuración validada, mientras que la imagen base puede aplicar un perfil general compatible con el hardware cuando no encuentra uno para el modelo solicitado.
 Admin
Bill Pearson, vicepresidente de Software para Centros de Datos del Data Center Group de Intel, describió el origen de los ajustes incluidos en los contenedores y el compromiso de la compañía con los proyectos abiertos.
“Las optimizaciones que sustentan esta versión son las mismas que Intel aporta de forma abierta a los propios marcos de trabajo sobre los que las empresas ya desarrollan, incluido vLLM. Intel Inference Microservices empaqueta ese trabajo detrás de una API estándar, por lo que los clientes obtienen una pila optimizada sin tener que realizar los ajustes por sí mismos. Nos comprometemos a seguir aportando optimizaciones a esos proyectos a medida que extendemos la misma interfaz a todo nuestro portafolio de hardware”.
Compatibilidad actual y funciones previstas
El software admite Docker o Kubernetes 1.24 y versiones posteriores y trabaja en precisión BF16, con 32 GB de RAM sugeridos. OpenAI SDK, LangChain, LlamaIndex, LiteLLM y Haystack pueden conectarse modificando la URL base, incluido el uso de respuestas en streaming.
Las llamadas a herramientas y las salidas estructuradas pueden utilizarse a través de vLLM, aunque aún no están validadas en estos microservicios. Intel prevé incorporar un chart de Helm, un operador de Kubernetes, otros motores y precisiones adicionales.
Intel prevé ampliar el soporte a sus GPU, incluida Crescent Island para inferencia en centros de datos, manteniendo la misma API para trasladar cargas entre sus plataformas sin reescribir las aplicaciones.