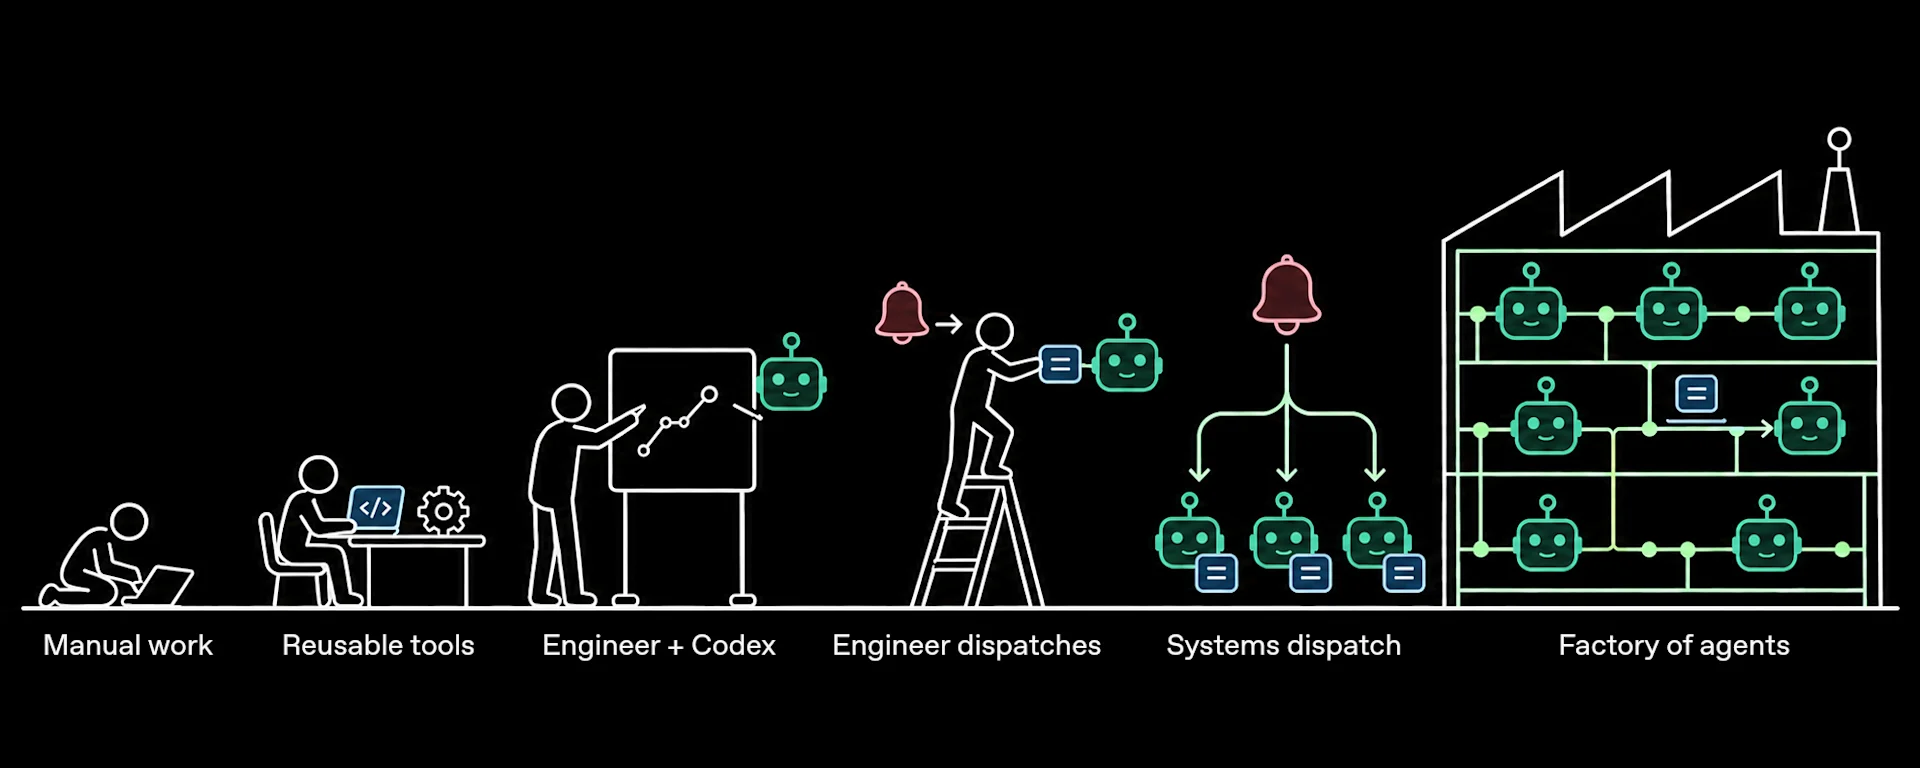
OpenAI desarrolló Performance Factory, un sistema interno que utiliza agentes de Codex para investigar problemas de rendimiento en ChatGPT, proponer modificaciones de código y comprobar sus resultados después del despliegue. Su implementación busca reducir las investigaciones manuales que realizan los equipos de ingeniería.
El sistema mantiene un registro de cada investigación y coordina distintas sesiones de Codex para continuar el trabajo cuando se completa una revisión o se introduce un cambio en producción. Los ingenieros conservan la responsabilidad de aprobar e implementar las correcciones propuestas.
Performance Factory coordina agentes de Codex para investigar y corregir regresiones
El proceso comienza cuando una alerta detecta una degradación del rendimiento. Un agente examina las métricas afectadas, identifica cuándo comenzó el problema y analiza registros, trazas y modificaciones recientes del código para determinar las posibles causas.
Performance Factory utiliza cuatro componentes principales: un servicio que administra las tareas y sus estados, un mecanismo que distribuye el trabajo entre agentes, una API interna para ejecutar Codex en la nube y suscripciones que permiten reanudar las investigaciones ante nuevos eventos.
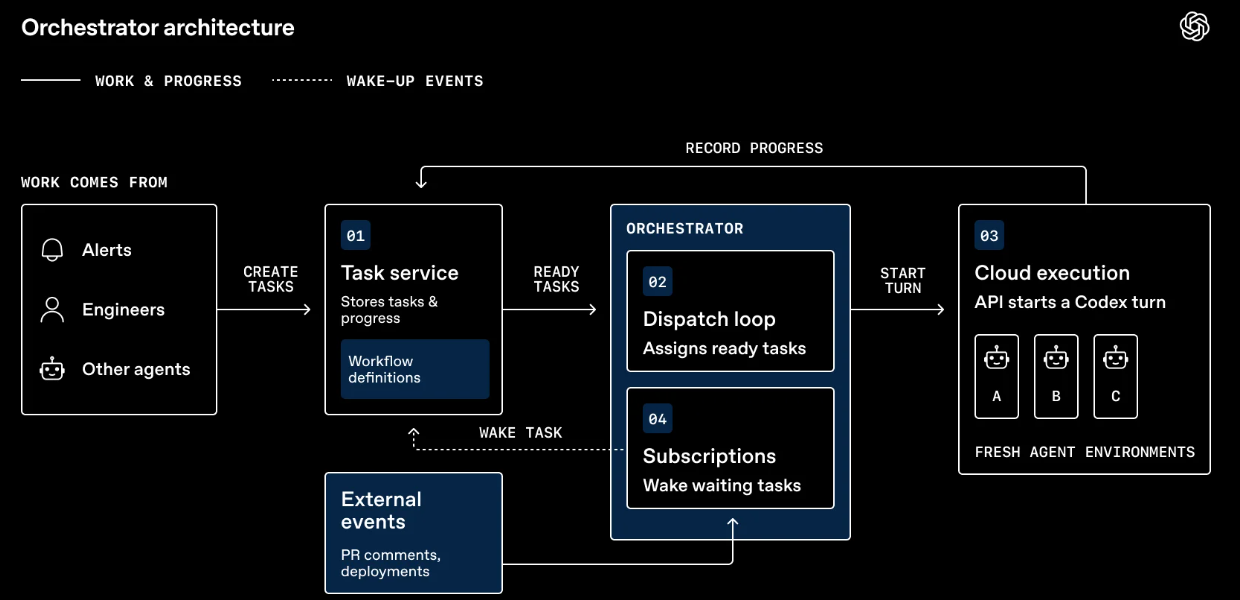
Los agentes acceden a herramientas de observabilidad y repositorios internos mediante identidades de servicio con permisos delimitados. Para realizar los diagnósticos utilizan perf-forensics, una skill desarrollada por OpenAI que reúne instrucciones y herramientas especializadas en investigaciones de rendimiento.
Una segunda sesión independiente de Codex realiza una revisión adversarial del diagnóstico, intentando refutar las conclusiones iniciales. Este procedimiento surgió después de comprobar que algunos agentes aceptaban explicaciones aparentemente correctas sin establecer completamente la relación entre una modificación y el problema detectado.
Cuando se identifica una posible solución, Codex prepara los cambios y abre una pull request para su revisión. Después de que un ingeniero despliega la corrección, otro agente comprueba si las métricas recuperaron sus valores anteriores.
 Admin
Más de 1700 investigaciones automatizadas y los límites detectados
Durante poco más de tres meses, Performance Factory realizó más de 1700 investigaciones e identificó la causa raíz en más de 600 casos, según los resultados publicados por OpenAI. La compañía calcula un promedio de 17 investigaciones automatizadas diariamente.
Sin embargo, los diagnósticos todavía presentan limitaciones. En una revisión manual de 100 causas raíz propuestas por los agentes, el 70% fue considerado correcto, mientras que el 30% restante necesitaba ajustes adicionales o no demostraba completamente la causalidad del problema.
La elaboración de correcciones también ha presentado dificultades, especialmente cuando los agentes proponen modificaciones innecesariamente complejas o introducen nuevos problemas. Por este motivo, OpenAI incorporó revisiones independientes de las soluciones y mantiene la intervención humana en las decisiones de implementación.
 Admin
La compañía trabaja además en mecanismos para identificar degradaciones antes de que se activen las alertas, mediante el análisis de perfiles de CPU, memoria y trazas. También estudia automatizar la integración de determinadas correcciones de bajo riesgo, una capacidad que todavía se encuentra en desarrollo.