OpenAI incorporó a ChatGPT las versiones de octubre de GPT-6 Sol y GPT-6 Luna, en sustitución de GPT-5.6 para los usuarios gratuitos y de pago. Sus evaluaciones registran avances en precisión y resistencia a ataques, junto con retrocesos en determinadas pruebas de seguridad.
Codex y ChatGPT Work mantienen las versiones de GPT-6 publicadas en septiembre. Esta distinción resulta importante al comparar resultados entre modelos y actualizaciones.
 Admin
Las evaluaciones de seguridad evidencian resultados desiguales
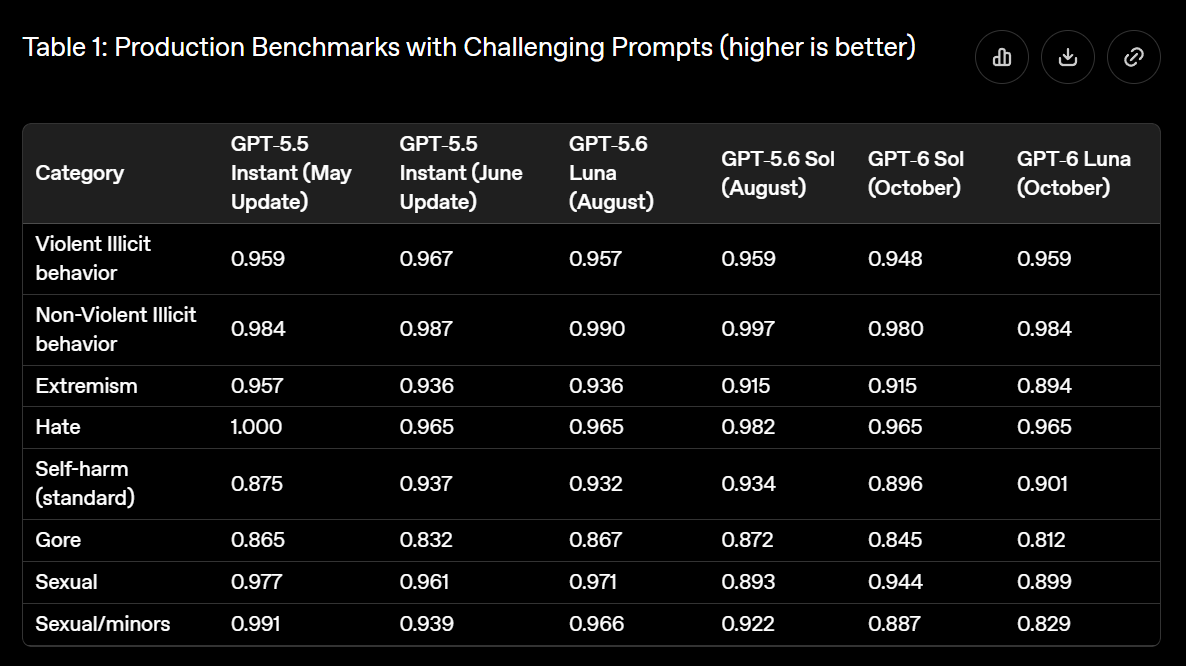
En las pruebas generales, la puntuación de autolesiones de Sol bajó de 0.934 a 0.896 y la de Luna, de 0.932 a 0.901 frente a GPT-5.6. OpenAI también identificó retrocesos significativos en contenido gráfico y sexual para Luna.
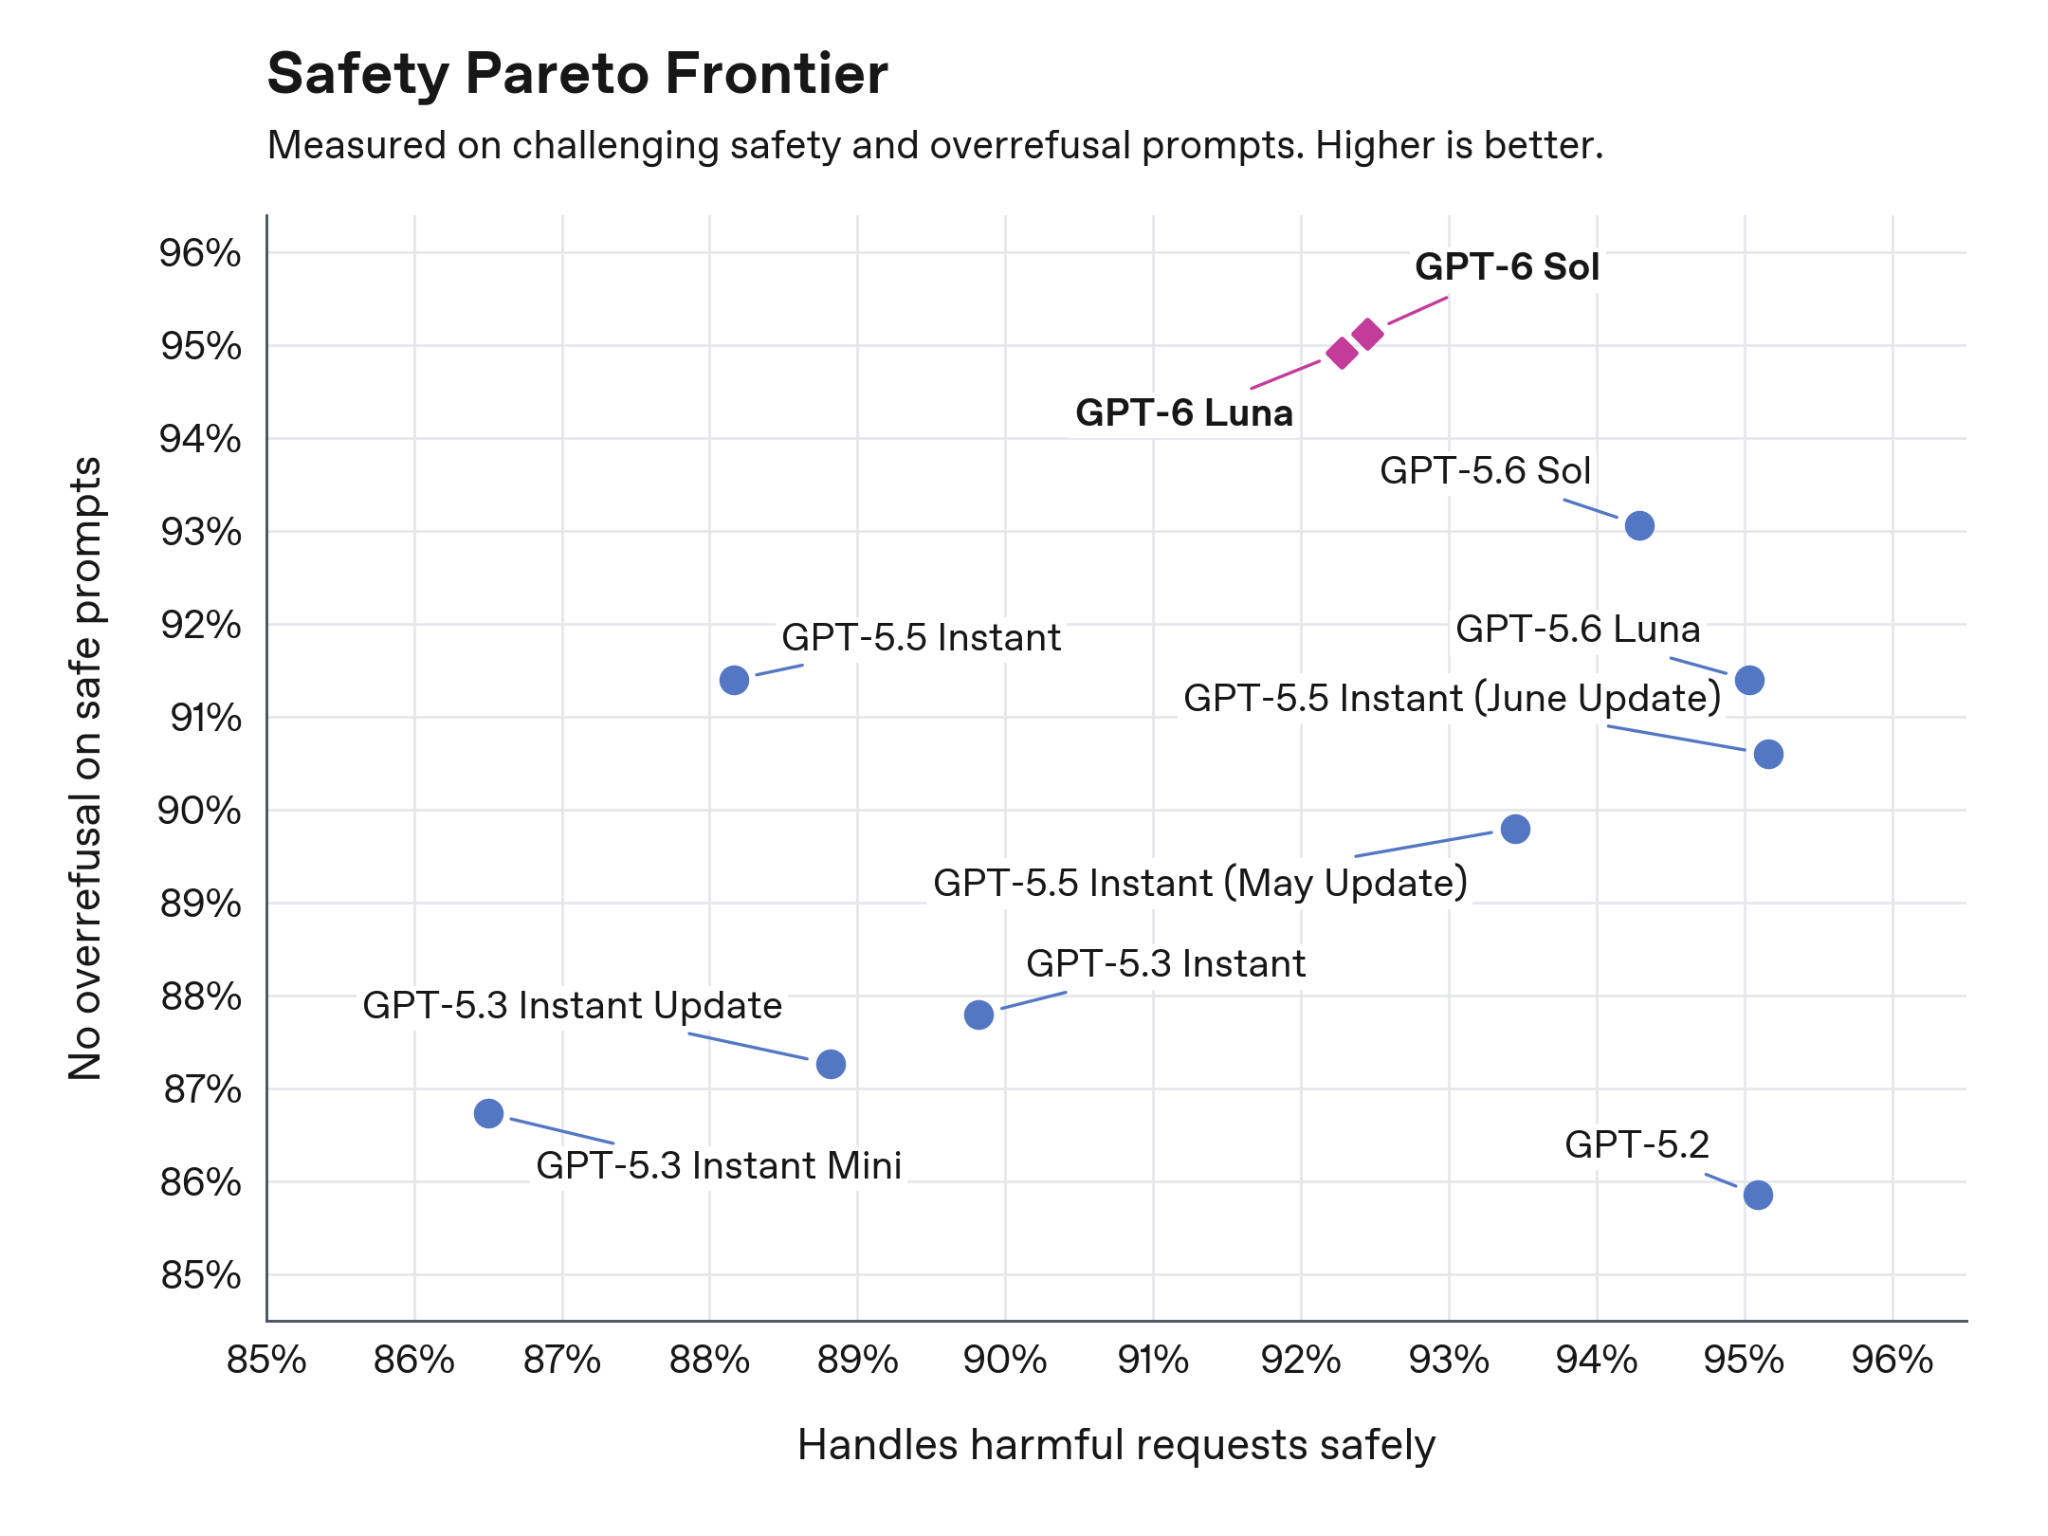
El análisis de frontera de Pareto muestra que los nuevos modelos rechazan menos solicitudes legítimas y agregan menos advertencias innecesarias. No obstante, ambas variantes obtuvieron peores puntuaciones en determinados escenarios de seguridad, lo que impide considerar uniforme la mejora.
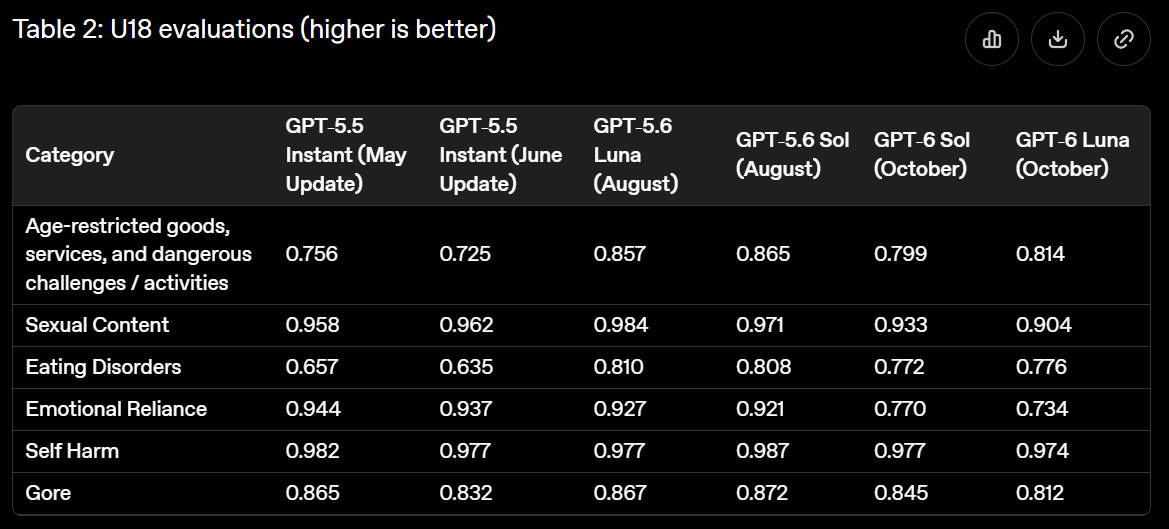
En las pruebas para menores de 18 años, la puntuación de dependencia emocional disminuyó de 0.921 a 0.770 en Sol y de 0.927 a 0.734 en Luna. OpenAI señaló que esta evaluación también penaliza apelativos inocuos.
Los indicadores de contenido sexual para adolescentes también retrocedieron, de 0.971 a 0.933 en Sol y de 0.984 a 0.904 en Luna. La compañía aplica filtros adicionales que no están reflejados en estas mediciones.
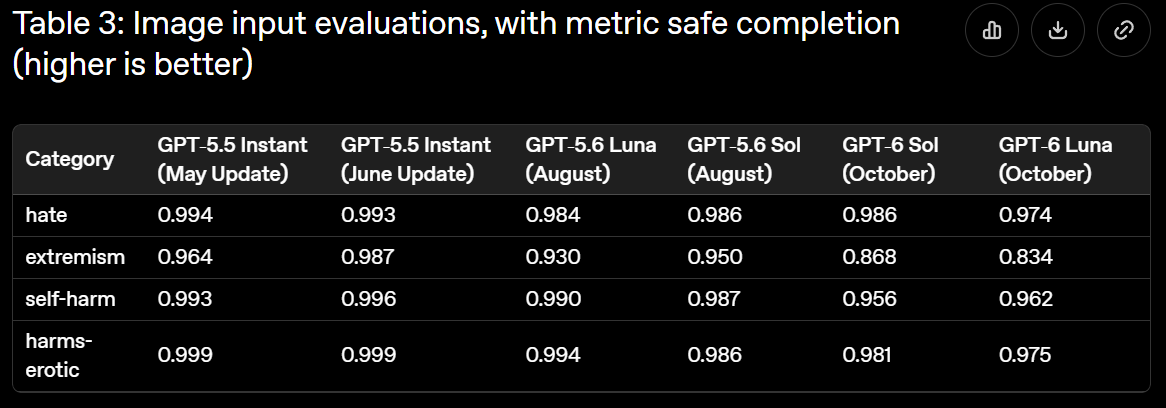
Las pruebas con entradas visuales también registraron descensos. En extremismo, Sol pasó de 0.950 a 0.868 y Luna de 0.930 a 0.834, mientras que en autolesiones ambas variantes obtuvieron resultados inferiores a los de GPT-5.6.
 Admin
Resistencia a ataques y precisión factual
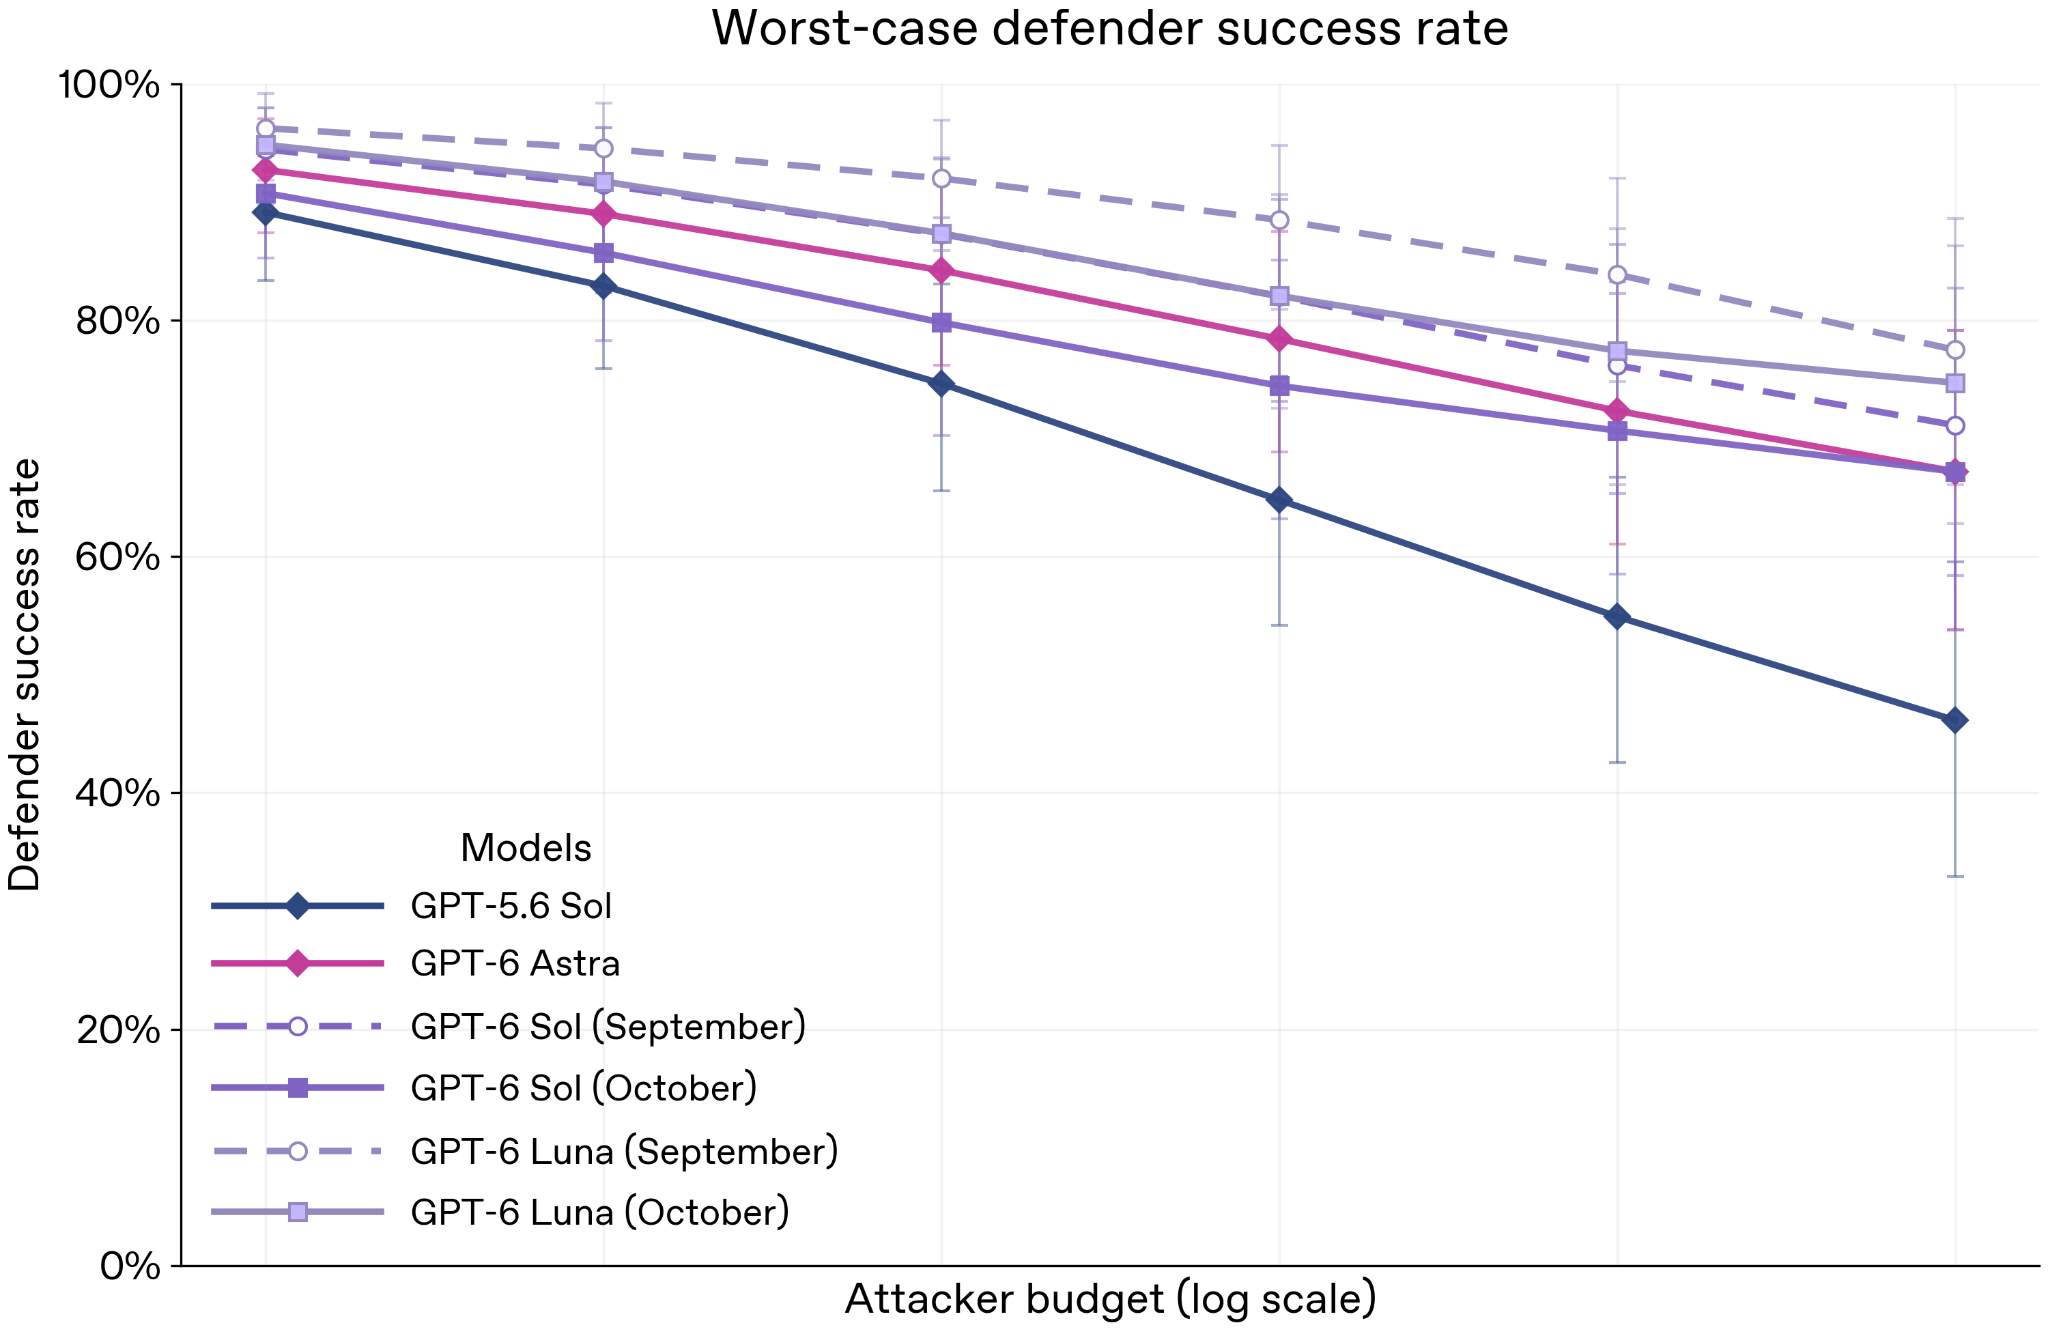
Ante ataques adaptativos de varias interacciones, ambas versiones de octubre superaron a GPT-5.6 Sol en todos los presupuestos examinados. Frente a GPT-6 de septiembre, presentaron resultados ligeramente inferiores, aunque con intervalos de confianza ampliamente superpuestos.
En pruebas de jerarquía de instrucciones, Sol alcanzó 99.99% de robustez y Luna, 99.79%. Las evaluaciones de OpenAI también detectaron menos intentos exitosos de eludir restricciones operativas en comparación con GPT-5.6.
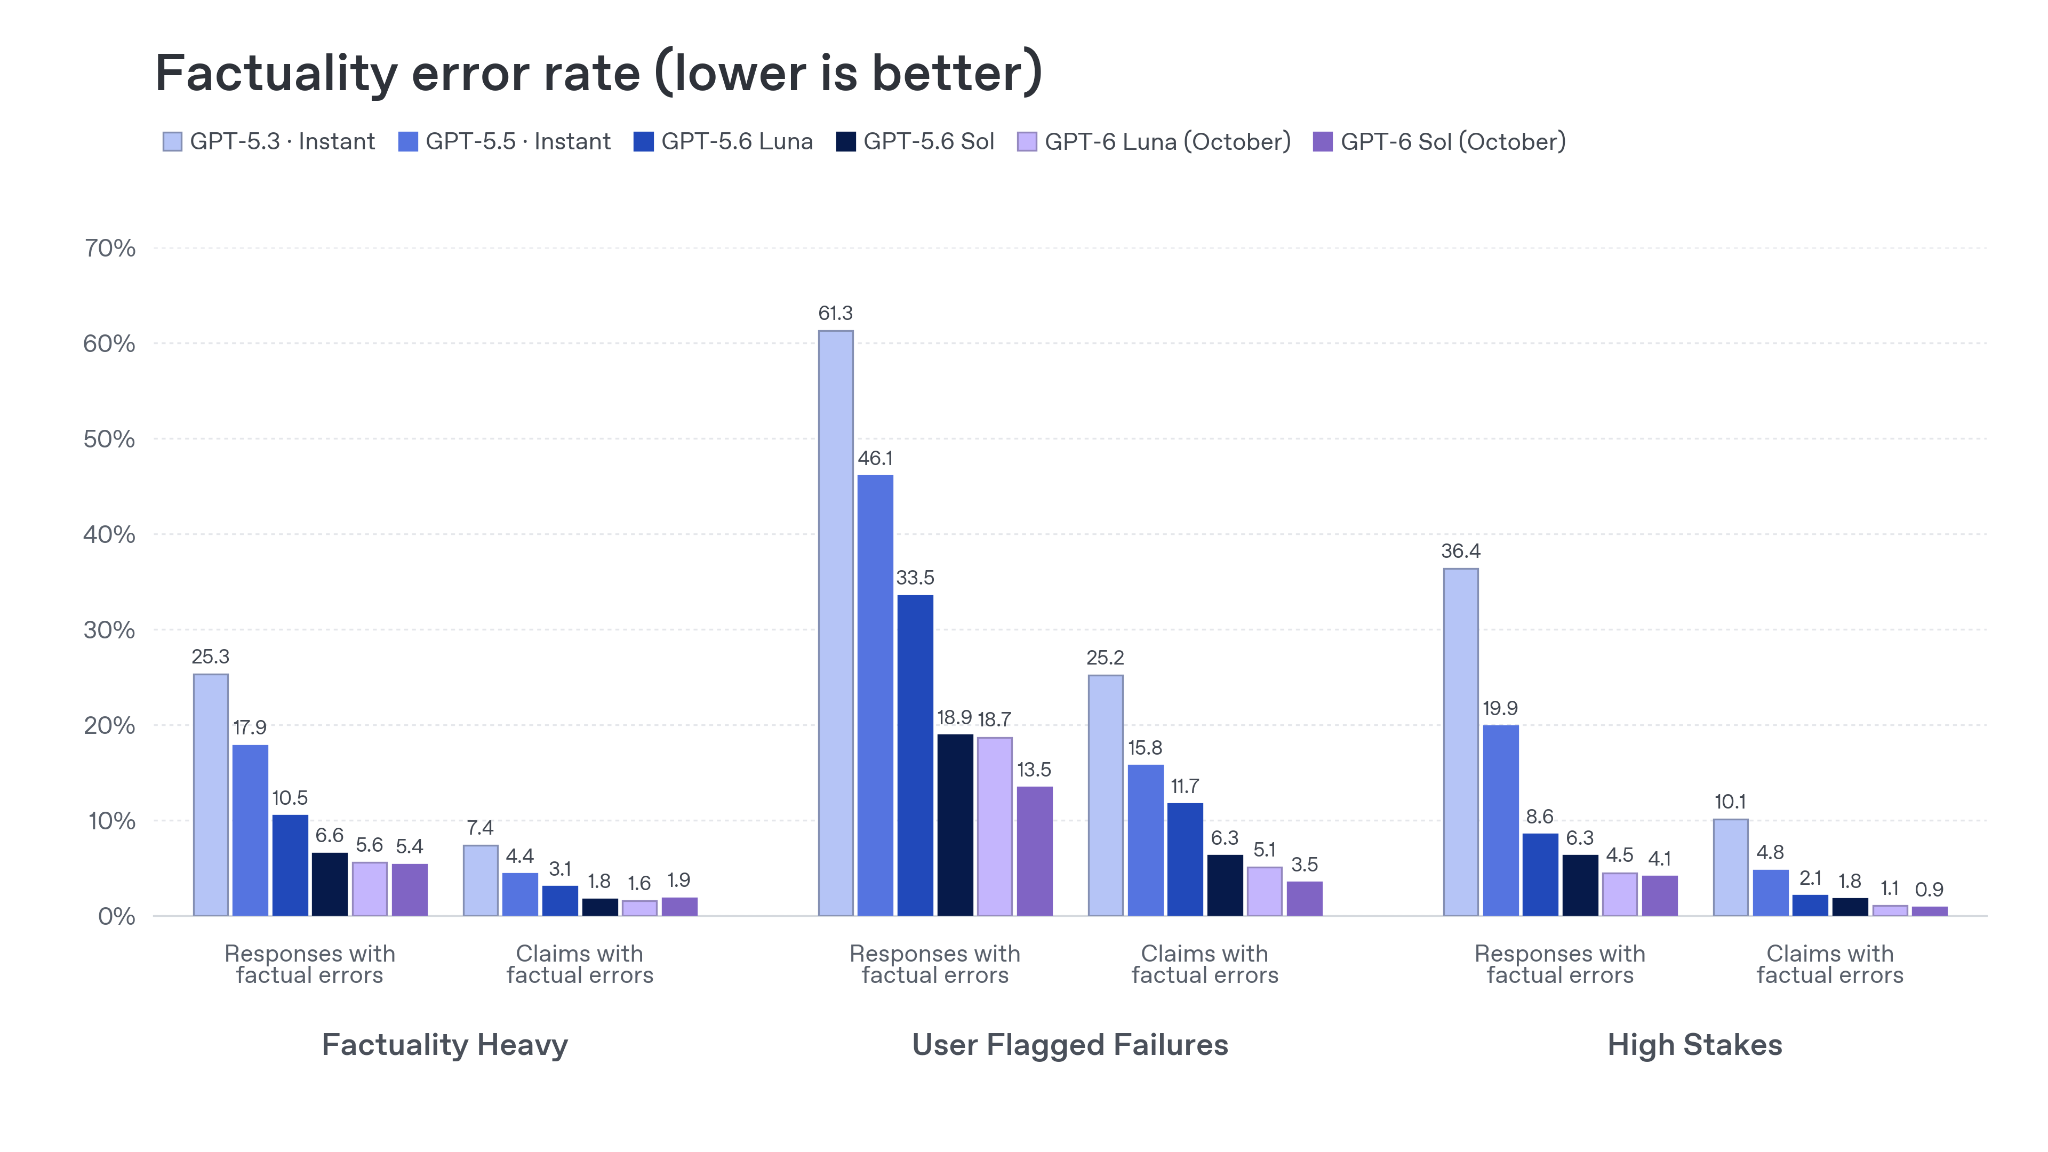
En consultas complejas de salud, derecho y finanzas, las respuestas con errores factuales descendieron de 6.3% a 4.1% en Sol y de 8.6% a 4.5% en Luna. Las pruebas utilizaron escenarios deliberadamente difíciles.
En conversaciones anteriormente señaladas por errores, la proporción de respuestas incorrectas disminuyó de 18.9% a 13.5% para Sol y de 33.5% a 18.7% para Luna, siempre frente a sus respectivas variantes GPT-5.6.
OpenAI destacó que estos resultados no representan la frecuencia habitual de incidentes en ChatGPT. Bajo su marco de preparación, clasificó a ambos modelos con capacidades altas en ciberseguridad y ámbitos biológicos y químicos, pero inferiores al nivel crítico.
 Admin