La computación de alto rendimiento o HPC combina múltiples recursos para ejecutar cargas mediante paralelismo, redes de baja latencia, almacenamiento de alto rendimiento y software especializado. Cuando estos recursos se organizan como nodos coordinados aparece el clúster, una de las arquitecturas fundamentales sobre las que se construyen los sistemas HPC.
 Ivan
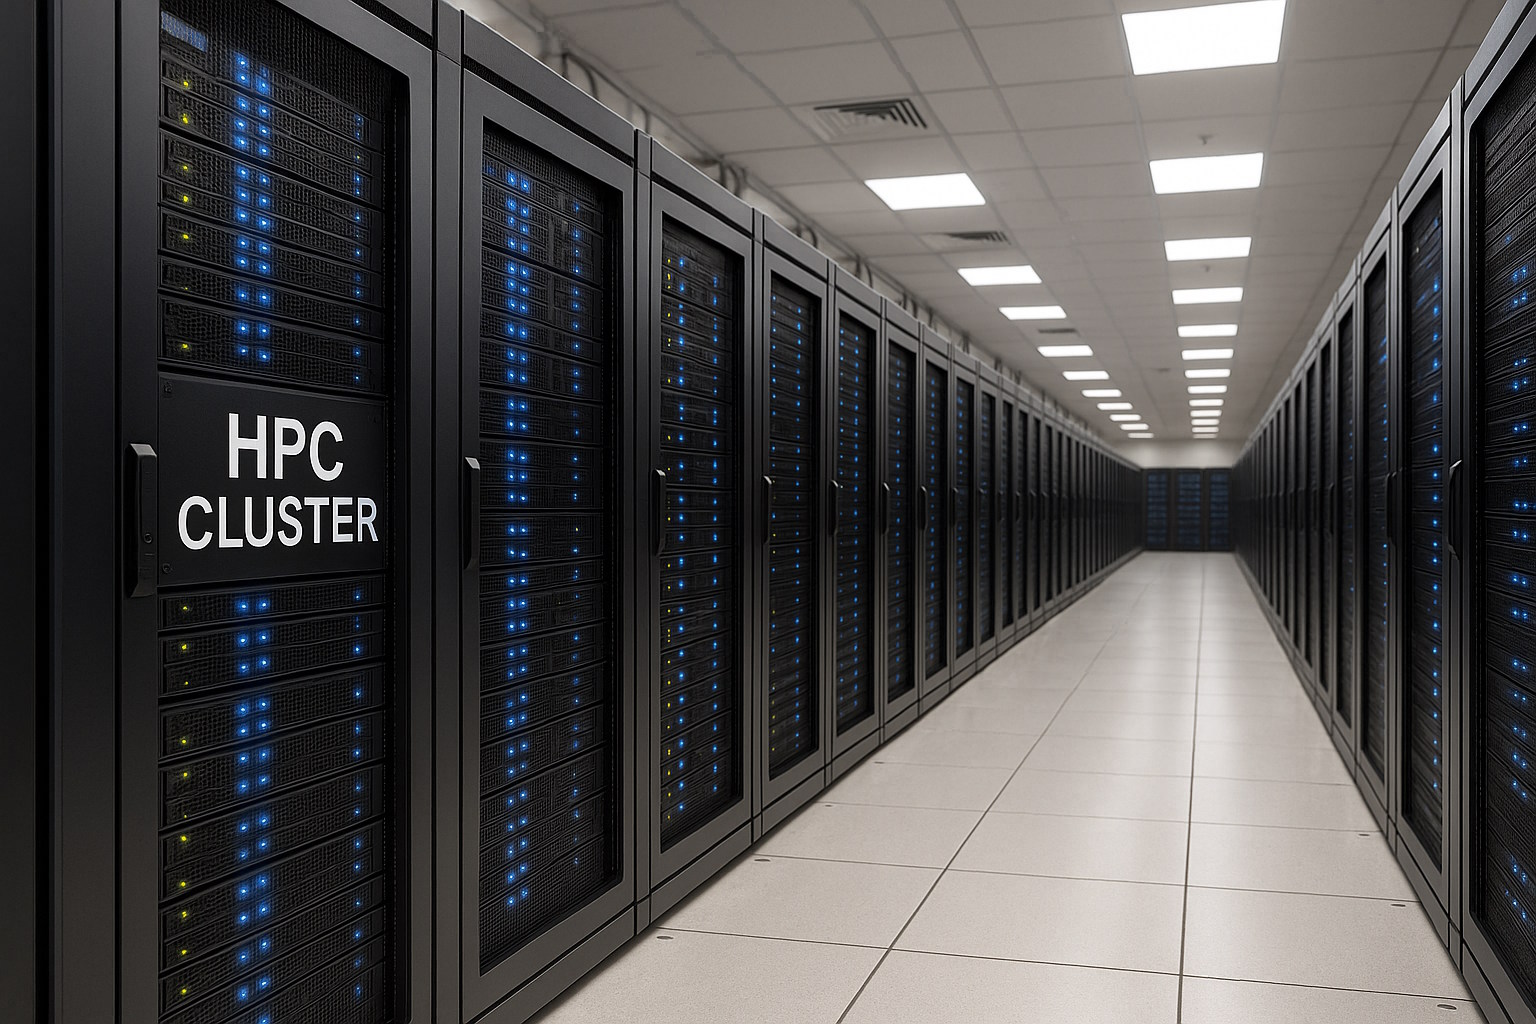
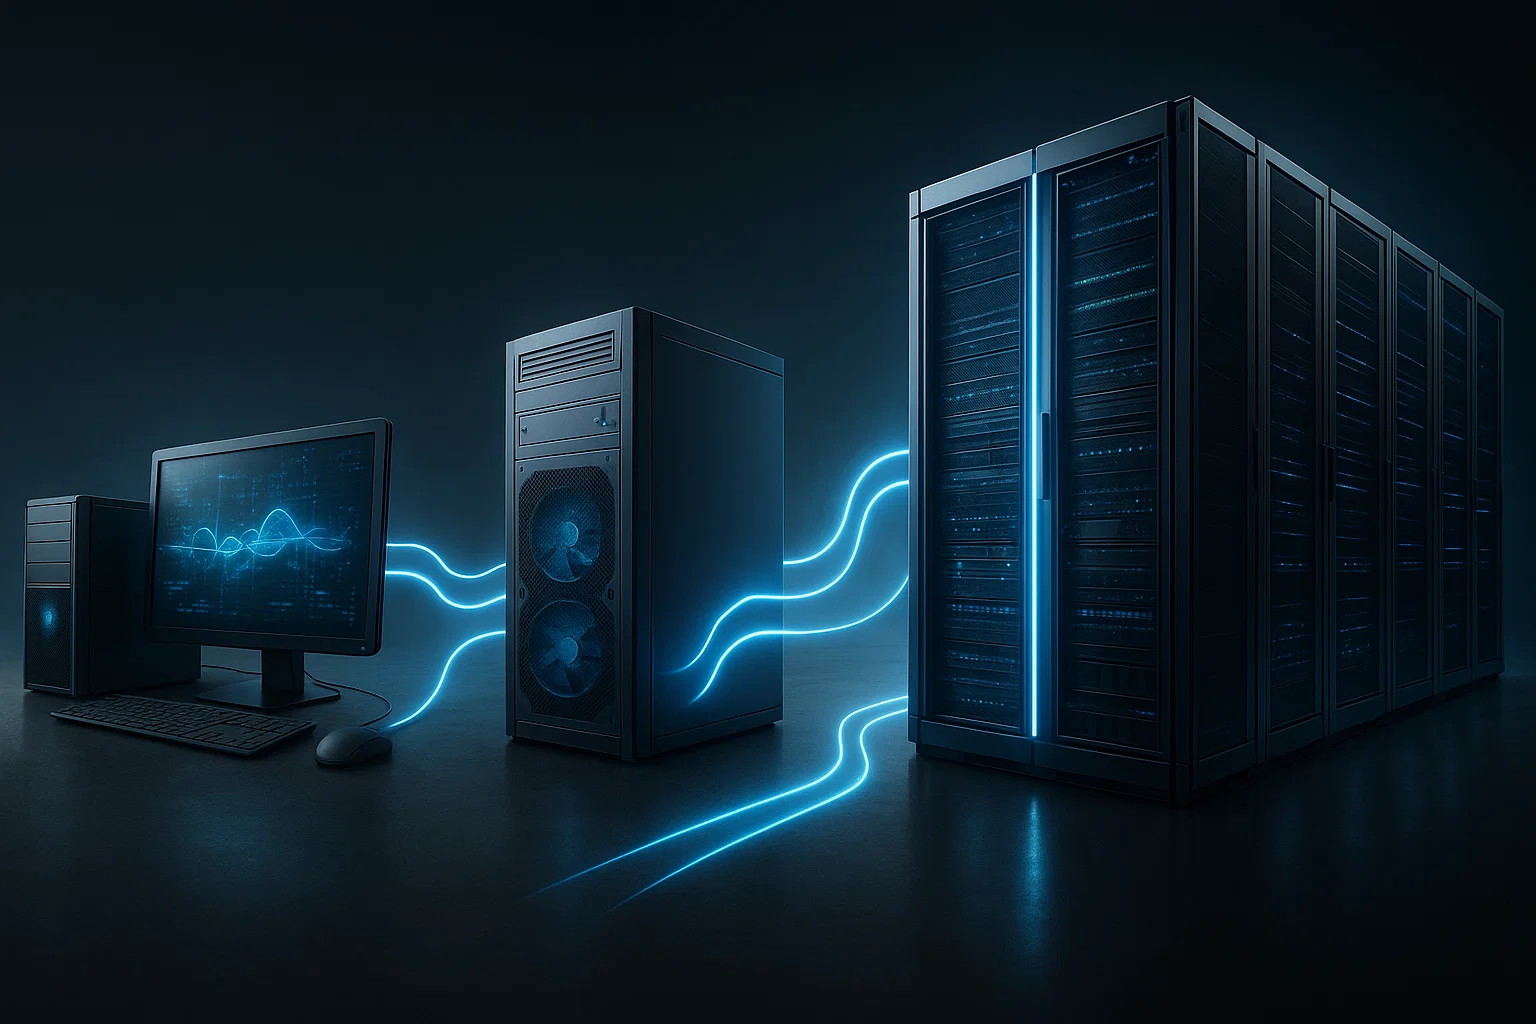
Estas arquitecturas pueden crecer desde una workstation y pequeños conjuntos de servidores hasta grandes supercomputadores. En el extremo superior aparece la computación exaescala, donde la coordinación entre miles de procesadores, aceleradores, memoria, almacenamiento y redes resulta tan importante como la capacidad individual de cada componente.
 Ivan
¿Dónde encajan PoD y SuperPoD?
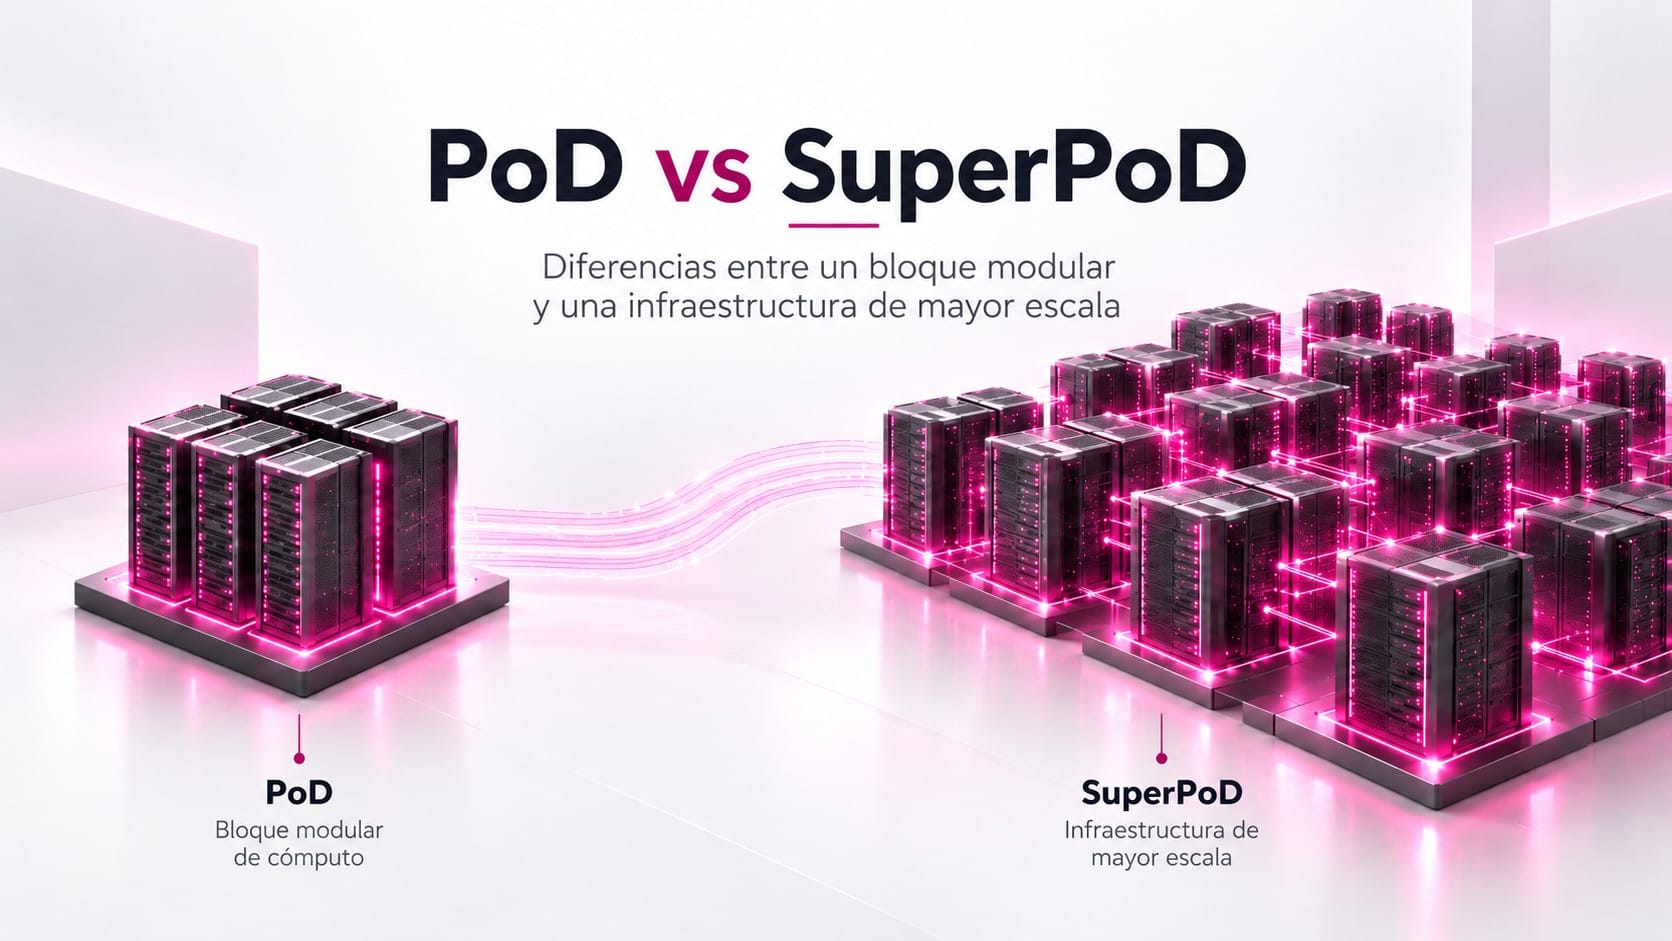
Un PoD agrega una capa de organización sobre estos recursos, al definir un bloque modular de infraestructura con cómputo, red, almacenamiento y administración. No reemplaza al concepto de clúster, ya que describe principalmente cómo se estructura y despliega físicamente una parte de la infraestructura.
El SuperPoD lleva esa integración a escalas mayores y con interconexiones diseñadas para cargas intensivas de HPC e inteligencia artificial. NVIDIA, por ejemplo, define DGX SuperPOD como una arquitectura modular que integra sistemas DGX, redes, almacenamiento y software para cargas de IA, HPC y aplicaciones híbridas.
 Admin
¿Y qué es un SuperCluster?
El SuperCluster vuelve a describir una agrupación masiva de recursos, aunque su relación con SuperPoD depende del fabricante. Huawei permite conectar múltiples SuperPoD mediante UnifiedBus o RoCE para construir SuperClusters que escalan a cientos de miles de NPU.
Esta convergencia también explica por qué HPC e IA pueden compartir infraestructura, aunque sus cargas utilicen distintas precisiones numéricas y patrones de procesamiento.
 Ivan