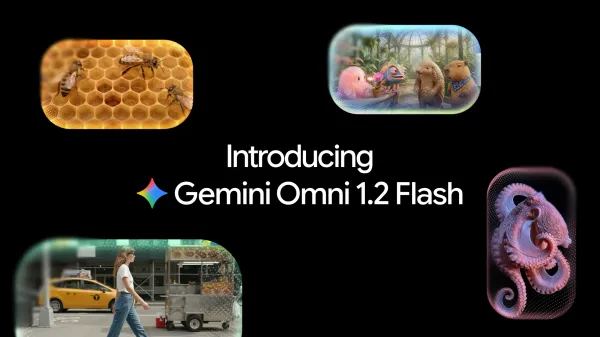
Google presentó Gemini Omni 1.2 Flash, una actualización de su modelo de generación de video que incorpora edición mediante instrucciones sucesivas y mayor control sobre imágenes y audio utilizados como referencia.
Los clips duran entre 3 y 15 segundos, configurables en intervalos de un segundo, frente al máximo de 10 segundos de Gemini Omni 1.1. Google fijó en USD 0.07 por segundo el precio de generación a 720p, un 30% menos que la versión anterior.
 Admin
Edición por instrucciones y continuidad de las referencias
Las referencias de entrada pueden combinar fotografías de personajes, productos o estilos, secuencias de movimiento de hasta tres segundos e indicaciones de audio. De acuerdo con Google, el nuevo modelo mantiene con mayor estabilidad elementos como rostros, vestuario, tipografías de envases y colores entre ángulos de cámara.
Con nuevas instrucciones es posible cambiar productos, fondos, iluminación, clima o relación de aspecto sobre un video ya generado. El modelo también permite interpolar entre fotogramas inicial y final o extender un clip, con menor variación de objetos y escenas, según la compañía.
 Admin
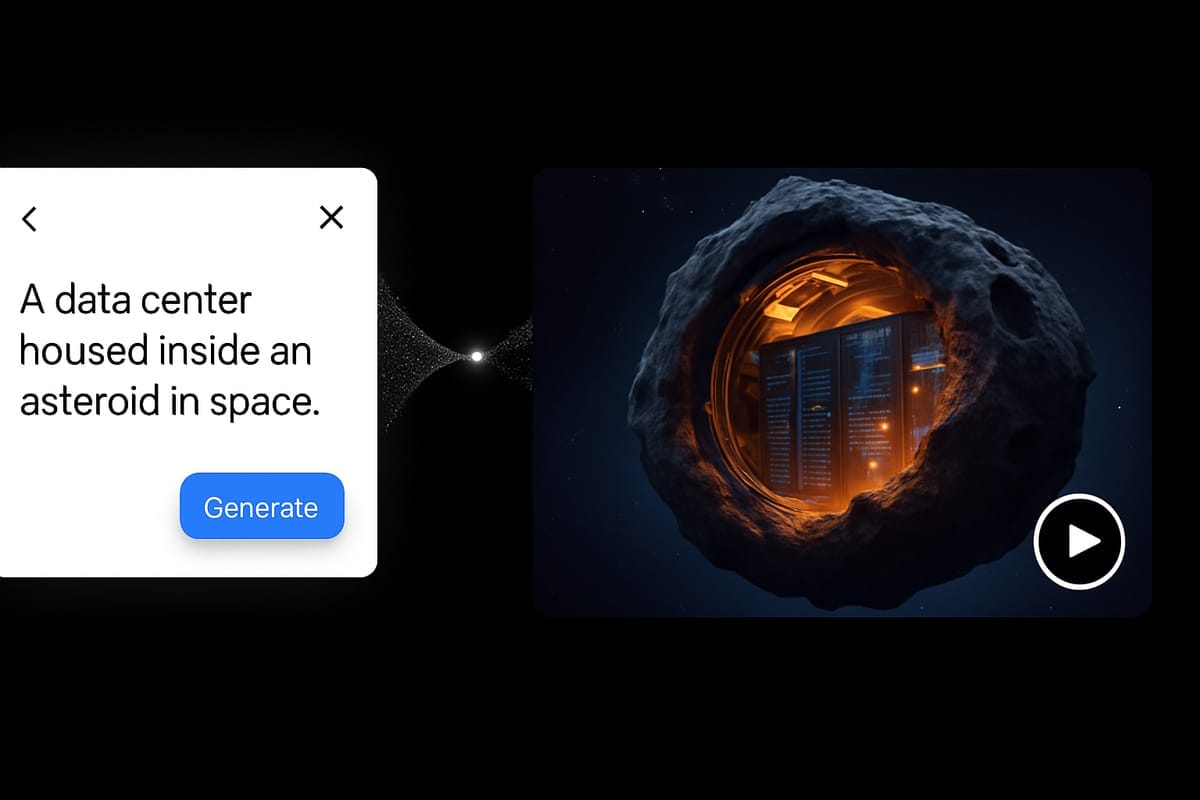
Para preparar las secuencias, el flujo admite borradores en 360p o 720p y ampliación posterior a 1080p o 4K de las versiones seleccionadas. Google declara mejoras en la sincronización labial de diálogos con varios participantes y en la continuidad de movimientos de cámara complejos.
Disponibilidad en servicios de Google y limitaciones del modelo
El modelo tiene disponibilidad general mediante Gemini API y Gemini for business, con herramientas en Google AI Studio y Google Cloud. Las funciones llegan a Flow, Google Vids y Google Ads, mientras que la aplicación Gemini las está incorporando gradualmente para quienes tienen Google AI Ultra.
Según Google, en Vids se pueden generar clips de 15 segundos sin costo adicional con una cuenta de Google o una suscripción a Workspace.
Los videos llevan una marca de agua imperceptible SynthID, mientras que Google Cloud dispone de Provisioned Throughput para empresas.
 Admin
Google reconoce que todavía trabaja en mejorar la generación de escenas con acciones deportivas rápidas, cambios rápidos de guion y representación de fenómenos físicos complejos.