NVIDIA presentó Nemotron for Science, un conjunto de recursos basados en el modelo abierto Nemotron 3.5 Super VL para desarrollar agentes de IA destinados a la investigación científica. La iniciativa incluye datos de química, evaluaciones y procedimientos de posentrenamiento para adaptar el modelo a tareas específicas.
 Admin
Uno de sus componentes es LitmusBench v0.2, un conjunto abierto con casi 50.000 preguntas para entrenar y evaluar el razonamiento químico. Sus datos proceden de propiedades moleculares y experimentos de investigación farmacológica, incluidos aspectos como la solubilidad y el procesamiento de moléculas en el organismo.
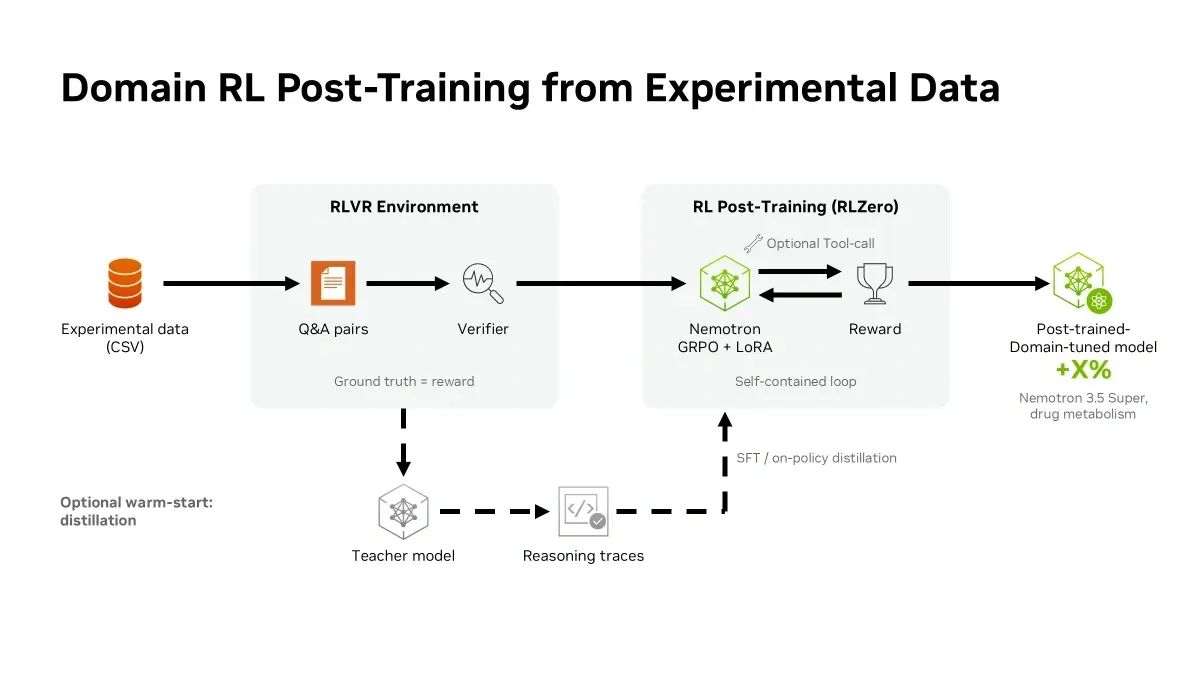
Posentrenamiento de Nemotron 3.5 Super VL y herramientas CUDA-X
Los investigadores pueden ajustar los modelos Nemotron con datos de sus disciplinas e integrarlos en agentes capaces de interpretar información científica, generar código y utilizar herramientas de cálculo. Entre los recursos contemplados están las herramientas aceleradas CUDA-X de NVIDIA.
Ian Buck, vicepresidente de computación de hiperescala y alto rendimiento de NVIDIA, abordó el papel de los modelos abiertos y los datos especializados en este desarrollo, así como el uso de herramientas de cálculo acelerado para tareas científicas.
“[...] Nemotron for Science proporciona a los investigadores modelos abiertos, datos científicos y procedimientos de posentrenamiento para desarrollar agentes especializados que razonen sobre problemas científicos y utilicen herramientas aceleradas por CUDA-X para convertir ideas en descubrimientos”.
 Admin
Pruebas en laboratorios y centros de investigación
Terray Therapeutics aplicó el posentrenamiento a la extracción de reactivos, productos y condiciones de reacción desde diagramas científicos. Según NVIDIA, el modelo superó resultados publicados en dos evaluaciones y recuperó aproximadamente el 76% de las reacciones anotadas en la prueba RxnScribe, conforme a sus criterios de comparación.
Lila Sciences generó protocolos ejecutables en laboratorios automatizados sin ajuste adicional. Tras posentrenar el modelo con retroalimentación experimental, la precisión para fabricar puntos cuánticos llegó al 61%, frente al 54% de GPT-6 Astra, con costos de inferencia entre 10 y 20 veces menores, según NVIDIA.
Therna y NVIDIA posentrenaron Nemotron para diseñar terapias de ARNm con agentes. Según NVIDIA, casi duplicó la precisión de predicción de intervalos de expresión de proteínas frente a modelos de frontera; sus explicaciones fueron preferidas a las del modelo base en el 96% de las comparaciones.
El Laboratorio Nacional Argonne está incorporando Nemotron a StructBioReasoner, un sistema multiagente para diseñar y evaluar candidatos terapéuticos basados en proteínas. El centro de supercomputación de Jülich también lo integra en agentes dedicados al descubrimiento científico y farmacológico.
Por su parte, KTH Royal Institute of Technology desarrolló un agente que corrige configuraciones de dinámica molecular de GROMACS. Durante una ejecución nocturna en un DGX Spark, reparó el 81% de los casos de prueba con razonamiento activado, y GROMACS verificó cada corrección de forma independiente.
RIKEN habilitó los modelos Nemotron mediante RiVault, su acceso de inferencia al supercomputador RIKYU AI. Nemotron 3.5 Super VL y LitmusBench v0.2 ya están disponibles en Hugging Face, y NVIDIA optimizó el modelo para ejecutarse localmente en un DGX Spark con 128 GB de memoria.
 Admin