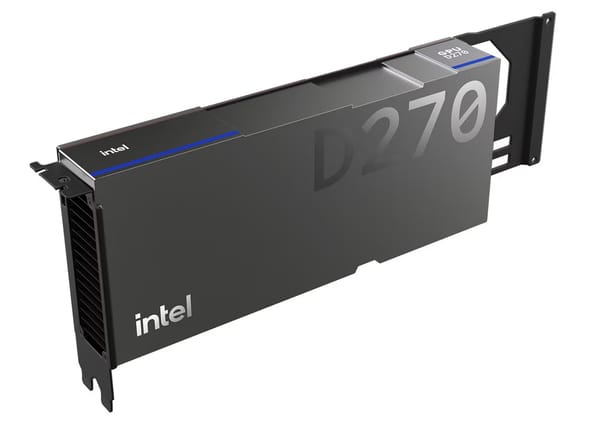
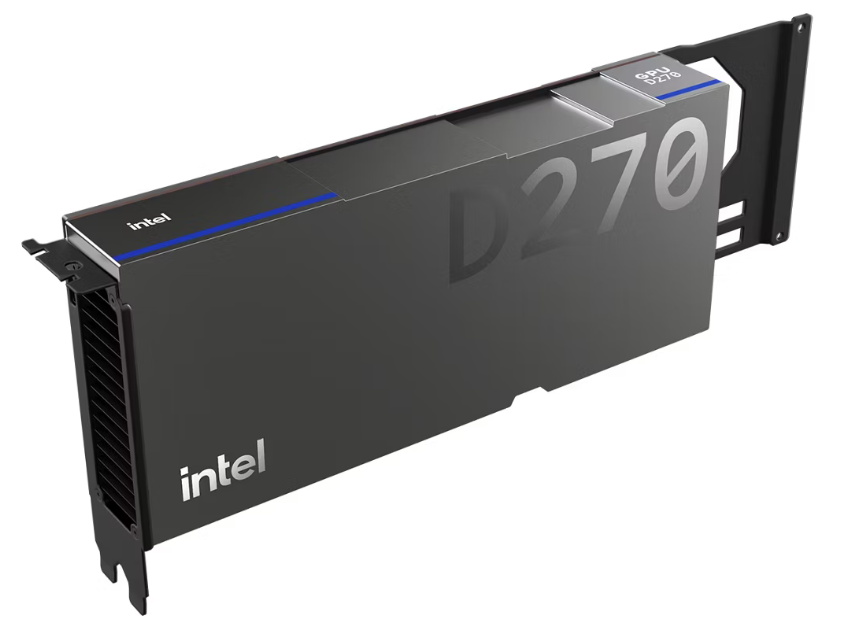
Intel publicó el 16 de noviembre especificaciones y pruebas de la GPU D270, antes conocida como Crescent Island, para cargas de computación de alto rendimiento (HPC). Los datos incluyen operaciones FP64, capacidad de memoria y ensayos realizados con silicio de preproducción.
Cálculo FP64, memoria y pruebas con cargas científicas
Basada en la arquitectura Xe 3P, la D270 integra 32 núcleos Xe y 256 motores Xe Matrix Extensions (XMX). Intel especifica 64 operaciones de multiplicación y suma fusionadas (FMA) en FP64 por núcleo, soporte nativo desde FP4 hasta FP64 y ejecución FP64 a tasa completa.
El modelo de Intel incorpora 160 GB de LPDDR5X y alcanza 1.5 TB/s de ancho de banda, mientras que las variantes diseñadas por socios pueden llegar a 480 GB de memoria. El diseño emplea PCIe 5.0, refrigeración por aire y un límite de potencia de 350 W.
 Admin
En pruebas de aplicaciones financieras con FP64, Intel midió la D270 frente a la NVIDIA RTX PRO 6000 Blackwell Server Edition. Obtuvo rendimientos de 5.9 veces en Monte Carlo europeo, 5.6 en Black-Scholes europeo, 4.6 en el modelo binomial y 1.92 en Monte Carlo americano.
La D270 se evaluó con silicio de preproducción y los ensayos utilizaron servidores con configuraciones diferentes, según el apéndice técnico publicado por Intel. El acelerador funcionó con un límite de 350 W, mientras que la GPU de NVIDIA tenía uno de 600 W.
Para simulaciones sísmicas, la D270 fue utilizada en una aplicación que realiza cálculos de propagación de ondas mediante FP32. Intel describió una demostración de Viridien para SC26, en Chicago, con optimizaciones de caché destinadas a reducir transferencias de grandes conjuntos de datos.
Según Intel, migrar la aplicación de HIP/CUDA a SYCL tomó menos de un mes, sin cambios en el código del anfitrión. El 90 % de los kernels mostró buen rendimiento sin ajustes específicos de Intel; los más complejos alcanzaron hasta el 70 % del máximo teórico.
Inferencia desagregada y herramientas de desarrollo
En inferencia desagregada, la D270 realiza el procesamiento inicial (prefill), intensivo en cómputo, y las unidades RDU SN50 de SambaNova asumen la generación de tokens (decode), limitada por memoria. Los procesadores Xeon 6 y Xeon 6+ coordinan el flujo y ejecutan herramientas.
 Admin
Intel anunció una demostración de esta configuración durante SC26, con ambos aceleradores operando conjuntamente. El objetivo declarado es insertar inferencia de IA agéntica en ciclos de simulación, donde las decisiones del modelo modifican los cálculos que se ejecutan a continuación.
En inferencia, Intel registró hasta un 29 % menos de latencia con DREX 2.0 y 1.12 veces el rendimiento de tokens con Qwen3-30B-A3B en FP8, frente a la RTX PRO 6000. Las mediciones se hicieron con hardware de preproducción.
El entorno de software incluye SYCL, Intel MPI y compiladores de Fortran y C++ optimizados, además de integración con sistemas de inferencia. Para la aplicación sísmica, Intel empleó compilación anticipada (AOT) y paquetes de kernels para reutilizar código desarrollado previamente.