En el contexto de Oracle AI World 2026, Autonomous AI Lakehouse plantea una forma de consultar datos empresariales distribuidos entre bases de datos, plataformas analíticas y almacenamiento de objetos. El servicio combina Oracle Autonomous AI Database, el formato abierto Apache Iceberg y herramientas para descubrir, analizar y compartir información sin exigir su traslado previo en todas las consultas.
La propuesta no debe confundirse con el lanzamiento de una nueva base transaccional ni con una migración automática de los datos de una empresa. Su alcance depende de los formatos admitidos, los catálogos conectados, los permisos de cada origen y la modalidad de procesamiento elegida.
 Admin
Qué función cumple la base de datos y qué añade el lakehouse
Oracle Autonomous AI Database proporciona el motor administrado que ejecuta consultas y dispone de funciones de analítica, aprendizaje automático, grafos y análisis espacial. La capa lakehouse amplía ese trabajo hacia conjuntos de datos almacenados fuera de la base, incluidos archivos y tablas accesibles a través de servicios de otras nubes.
 Francisco Carrasco M.
Los sistemas operacionales pueden conservar sus registros en Oracle Database o Exadata mientras se utilizan esos datos para análisis, sin que la consulta implique por sí misma una migración de la aplicación que los genera. Oracle describe la posibilidad de combinar mediante SQL información del lakehouse con datos empresariales ya disponibles en el entorno de base de datos.
La documentación distingue formatos de archivo, como CSV, JSON, XML, AVRO, ORC y Parquet, de formatos y mecanismos de intercambio, como Iceberg y Delta Sharing; también contempla documentos Word y PDF. Esa amplitud no significa que todos se traten como tablas Iceberg ni que tengan idénticas capacidades de consulta.
Apache Iceberg organiza las tablas sin imponer un motor único
Apache Iceberg es un formato abierto de tablas que organiza los metadatos necesarios para trabajar con conjuntos de datos en un lakehouse. Permite gestionar versiones y consultar información a gran escala, de modo que distintas herramientas compatibles puedan acceder a los datos sin depender de un formato de tabla exclusivo de Oracle.
Los archivos pueden mantenerse en almacenamiento de objetos mientras Oracle Autonomous AI Database consulta las tablas expuestas a través de Iceberg. En la descripción del producto, Oracle contempla consultas sobre esas tablas en su ubicación de origen y su combinación con otros datos mediante SQL, sin cargar previamente todo el conjunto en una tabla interna.
 Admin
La interoperabilidad requiere distinguir formato, catálogo y motor de procesamiento: compartir Iceberg no garantiza que cualquier función o versión sea admitida del mismo modo por todas las plataformas. La compatibilidad específica con cada origen y versión sigue siendo un punto que debe comprobarse en una implementación.
¿Cómo se habilita el acceso entre OCI y otras nubes?
La documentación de Oracle describe conexiones con lakehouses y almacenamiento de objetos situados en Oracle Cloud Infrastructure (OCI), AWS, Microsoft Azure y Google Cloud; la página del producto incluye además Exadata Cloud@Customer entre sus entornos de disponibilidad. Para acceder a cada origen deben concederse los privilegios correspondientes y configurarse las credenciales que utilizará Autonomous AI Database.
 Roberto Mera Velásquez
Para esos accesos, Oracle remite a mecanismos nativos de cada proveedor, entre ellos Amazon Resource Names (ARN) en AWS, entidades de servicio de Azure y cuentas de servicio de Google Cloud. La presencia de esos mecanismos es relevante porque desplegar un servicio en varias nubes no equivale a obtener acceso automático a todos los datos alojados en ellas.
 Francisco Carrasco M.
Una vez registrada la fuente o disponible su catálogo, las consultas SQL pueden combinar información externa con la almacenada en Oracle. El motor procesa la consulta, pero la obtención de los datos y metadatos externos sigue condicionada por los servicios, permisos y conexiones que intervienen.
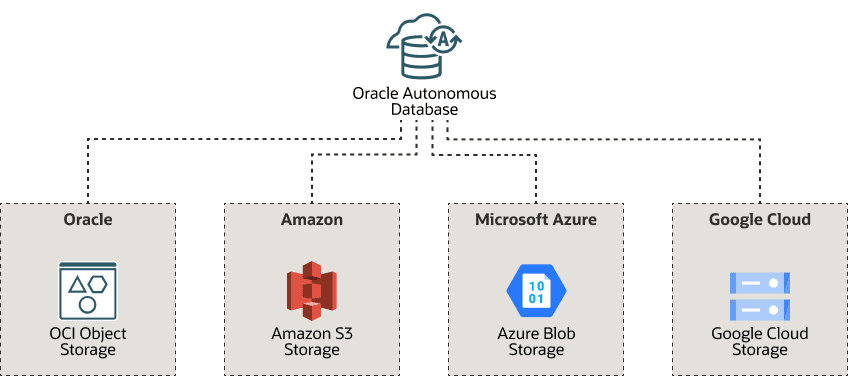
El catálogo unificado permite localizar y describir los datos
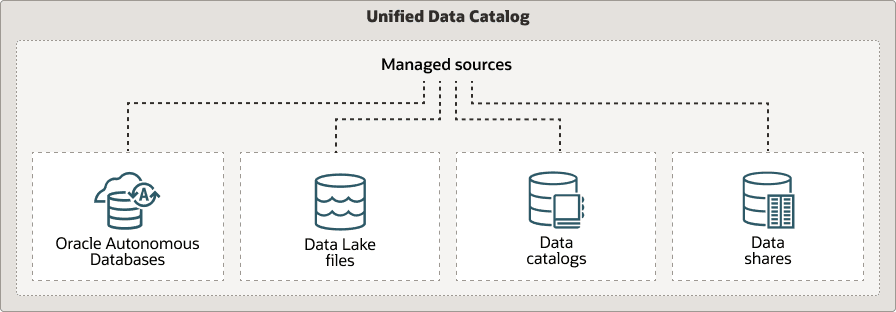
La función del catálogo no consiste en almacenar necesariamente una copia de cada conjunto de datos, sino en ofrecer una vista de las fuentes y sus metadatos. Oracle Autonomous AI Lakehouse Data Catalog incorpora información sobre tablas, columnas, enlaces a almacenamiento, modelos empresariales y vistas analíticas, además de dependencias que ayudan a reconocer el efecto de cambios en los datos de origen.
Oracle identifica integraciones con OCI Data Catalog y AWS Glue, así como con catálogos Apache Iceberg utilizados en entornos como Databricks y Snowflake. También permite definir metadatos manualmente para archivos almacenados en servicios de objetos o inferir determinados atributos, como nombres de columnas y tipos de datos, al preparar archivos CSV.
 Jonathan Munizaga
La vista federada reúne descripciones procedentes de diversos sistemas para facilitar su descubrimiento y administración. Debe distinguirse esa capacidad documentada de la capa semántica empresarial que Oracle incluye entre los temas de la sesión LRN6065: la agenda anuncia ese enfoque, pero no establece por sí sola el detalle de todas las funciones disponibles.
Los permisos del origen siguen siendo parte de la seguridad
Acceder a datos externos exige configurar la autenticación y los privilegios de la conexión antes de ejecutar las consultas. Los mecanismos de seguridad de AWS, Azure, Google Cloud u OCI continúan interviniendo en el acceso, mientras que Oracle incorpora controles de seguridad y gobierno en el entorno de base de datos.
 Admin
Entre las funciones que Oracle atribuye a su plataforma se encuentran la identificación de datos sensibles, el enmascaramiento, las alertas sobre configuraciones o usuarios de riesgo y la auditoría de actividades críticas. Estas herramientas no eliminan la necesidad de revisar quién puede acceder a cada fuente, qué objetos se exponen y cómo se administran las credenciales.
La documentación consultada no establece una regla única para todas las combinaciones de proveedores, regiones, catálogos y versiones. Por ello, la arquitectura de acceso y el comportamiento ante cambios de permisos o indisponibilidad de un origen deben verificarse para cada conexión, en lugar de asumir una equivalencia general entre nubes.
¿Qué cambia en el rendimiento cuando los datos son externos?
Consultar archivos remotos no es lo mismo que leer una tabla interna, y Oracle documenta mecanismos diferentes para tratar esas cargas. Data Lake Accelerator traslada operaciones intensivas de exploración, filtrado, proyección y descompresión a recursos de cómputo que se asignan durante la ejecución de la consulta y se liberan al terminar.
Lake Cache responde a otro patrón: conserva localmente datos externos consultados con frecuencia para acelerar accesos posteriores. En ese caso sí existe una copia en caché, por lo que la afirmación de que el lakehouse siempre analiza datos sin moverlos necesita esa precisión.
El particionamiento implícito permite reconocer estructuras de carpetas con atributos incorporados en sus nombres, como país, año o mes, y omitir archivos ajenos a los filtros solicitados. De acuerdo con la documentación, puede combinarse con los otros mecanismos para consultar una parte frecuente de los datos desde la caché y explorar históricos mayores mediante Data Lake Accelerator.
Oracle orienta Lake Cache a consultas repetidas o paneles, Data Lake Accelerator a exploraciones extensas y el particionamiento implícito a conjuntos organizados por carpetas. No se desprende de esa clasificación una mejora porcentual universal ni un rendimiento equivalente para cualquier formato y fuente externa.
 Admin
De las consultas SQL a la analítica y los agentes
Sobre el acceso a datos, Oracle incorpora Data Studio como entorno para preparar, transformar, analizar y compartir conjuntos de información. La compañía señala que dispone de conectores para más de 100 fuentes de aplicaciones, bases de datos y servicios, además de herramientas visuales para trabajar con los datos y sus dependencias.
Select AI añade una interfaz de lenguaje natural que traduce preguntas en consultas SQL sobre bases de datos, archivos o tablas de un lakehouse. Esa función utiliza las fuentes a las que el entorno tiene acceso, pero no reemplaza las reglas de permisos ni convierte automáticamente cualquier conjunto de datos en información validada para una decisión empresarial.
 Admin
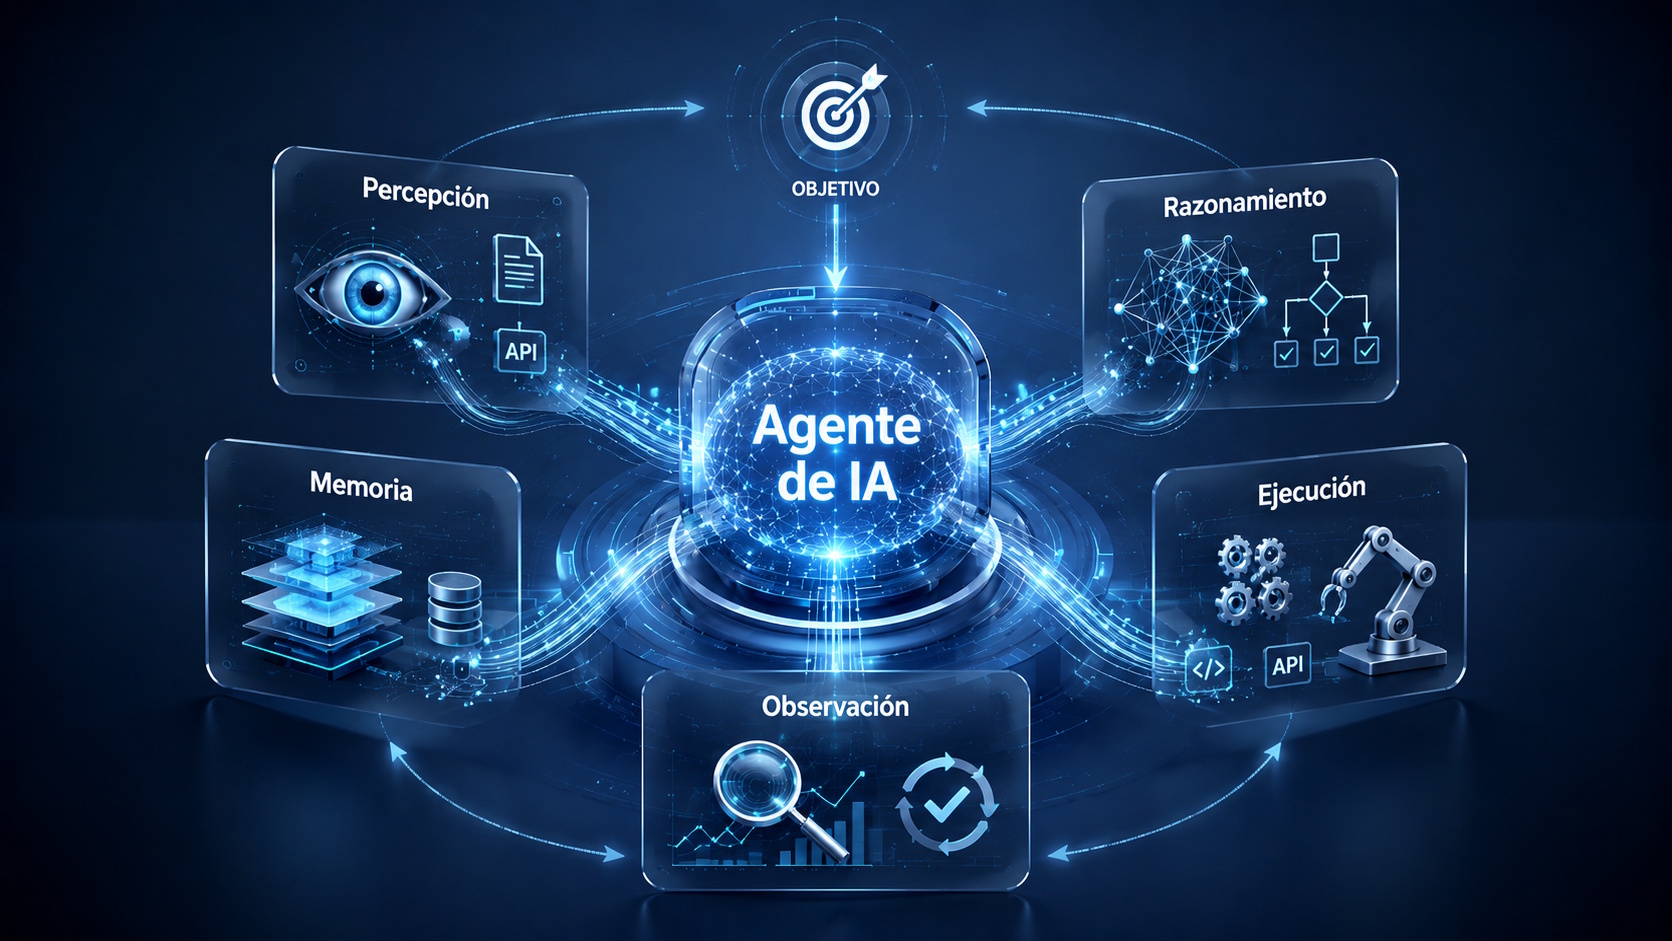
Las funciones de aprendizaje automático, grafos y análisis espacial pertenecen al conjunto de capacidades de Autonomous AI Database que Oracle plantea aplicar sobre datos accesibles mediante el lakehouse. Para los agentes, el alcance descrito en la agenda de Oracle AI World se concentra en disponer de contexto empresarial, catálogos, permisos y una interpretación compartida de los datos, sin presentar cada consulta como una acción autónoma ya ejecutada.
 Ivan
Compartir resultados no equivale a replicar todas las fuentes
La plataforma también distingue las consultas de los mecanismos empleados para distribuir información. Oracle menciona Delta Sharing para intercambios mediante un protocolo abierto con otros sistemas, Cloud Links para compartir datos entre instancias de Autonomous AI Database y enlaces de tablas orientados a consumidores REST, con controles sobre permisos y vencimiento.
 Fabrizio Ballarino
Data Studio incorpora funciones para ofrecer y consumir recursos compartidos, mientras Data Marketplace facilita descubrir conjuntos de datos disponibles para su análisis. Son alternativas con propósitos diferentes: un catálogo describe dónde encontrar un activo, una consulta lo procesa y un mecanismo de intercambio determina cómo se ofrece a otro consumidor.
¿Qué está documentado y qué debe comprobarse en LRN6065?
Oracle programó la sesión «Autonomous AI Lakehouse: What’s New and What’s Different» (LRN6065) para el 26 de octubre de 2026, de 11:30 a 12:15 horas de Las Vegas, en Titian 2204. Figuran como participantes Nipun Agarwal, vicepresidente sénior de Ingeniería de Software de Bases de Datos de Oracle; Vishal Singh, director sénior de Gestión de Producto de Autonomous AI Lakehouse en Oracle; y Rodrigo Assad, director de Innovación de Claro Brasil.
 Admin
El programa anticipa una discusión sobre catálogo central, capa semántica, Apache Iceberg, seguridad unificada, rendimiento de Exadata y conexiones con datos empresariales activos. No permite concluir que todas esas funciones se estrenen durante Oracle AI World 2026 ni identificar, antes de la sesión, qué parte corresponde a novedades frente a capacidades ya documentadas.
Quedan por precisar las diferencias funcionales según nube y modalidad de despliegue, los catálogos integrados sin configuración adicional, las operaciones admitidas sobre versiones concretas de Iceberg y los casos en que una consulta requiere copiar o almacenar datos en caché. También faltan condiciones de prueba para comparar el rendimiento de las consultas externas con el de alternativas que cargan previamente la información.