Oracle Cloud Infrastructure (OCI) reúne varias formas de ejecutar inteligencia artificial: desde servidores con aceleradores dedicados hasta servicios que entregan modelos mediante una API. La diferencia no es solo la cantidad de GPU contratadas, sino qué parte de la infraestructura administra el cliente y cuáles son las condiciones para poner una carga en producción.
La oferta combina cómputo, interconexión de alta velocidad, almacenamiento y herramientas para desplegar aplicaciones. Comprender esas capas permite distinguir una configuración diseñada para entrenar modelos de gran tamaño de otra destinada a atender solicitudes de inferencia, sin confundir las cifras máximas anunciadas con equipos disponibles en una región determinada.
 Admin
Esa distinción adquiere importancia ante Oracle AI World 2026, que se celebrará en Las Vegas y contará con sesiones dedicadas a la infraestructura de Oracle para inteligencia artificial. Entre ellas figura la presentación de Mahesh Thiagarajan, presidente de Oracle Cloud Infrastructure, programada para el martes 27 de octubre.
Por ahora, es posible explicar las capacidades que Oracle ya ha documentado, aunque algunos aspectos técnicos siguen pendientes de confirmación. Para conocer esos detalles, habrá que esperar a que se presenten los contenidos de las sesiones del evento.
Las cuatro capas de infraestructura que necesita una carga de IA
En la base están las instancias de cómputo con CPU y, cuando la aplicación lo requiere, GPU de NVIDIA o AMD. Sobre ellas se ejecutan los trabajos de procesamiento de datos, entrenamiento, ajuste de modelos e inferencia, mientras que los clústeres reúnen varios servidores para distribuir una misma tarea.
La segunda capa es la red. Para operaciones repartidas entre múltiples GPU, OCI dispone de interconexiones RDMA de baja latencia; para acceder a aplicaciones, datos y otros servicios también interviene la red convencional de la nube, que cumple una función diferente.
El almacenamiento forma una tercera capa con recursos locales NVMe, volúmenes de bloque, Object Storage y sistemas de archivos paralelos como Lustre. Finalmente están las herramientas de coordinación y los servicios administrados, entre ellos OCI Kubernetes Engine (OKE), OCI Generative AI y OCI Enterprise AI, cuyas responsabilidades operativas no son equivalentes.
 Ivan
¿Qué cambia al contratar GPU bare metal o máquinas virtuales?
OCI Compute contempla instancias bare metal, que entregan acceso al servidor físico sin la capa de un hipervisor, y máquinas virtuales (VM), que permiten utilizar recursos virtualizados. La elección depende de la configuración disponible, el tamaño del trabajo y el control requerido sobre el entorno de ejecución; contratar una instancia con GPU no equivale a disponer automáticamente de un clúster de entrenamiento distribuido.
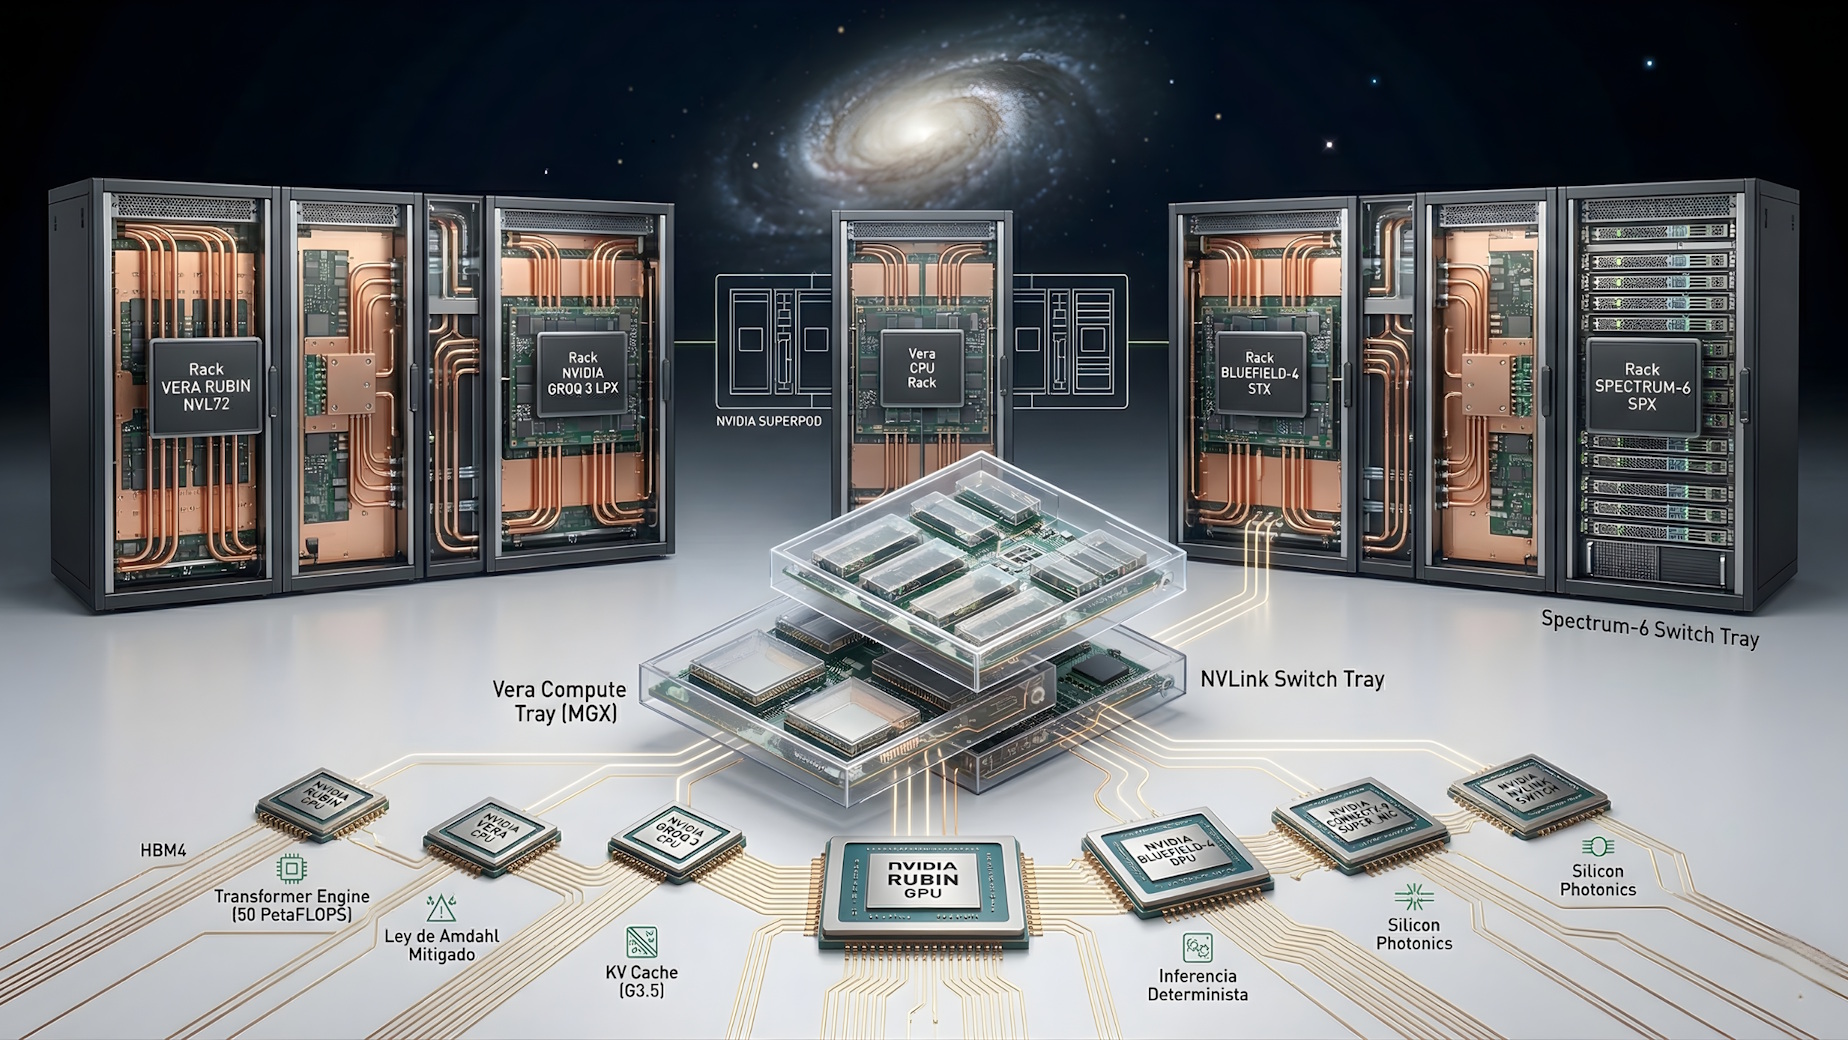
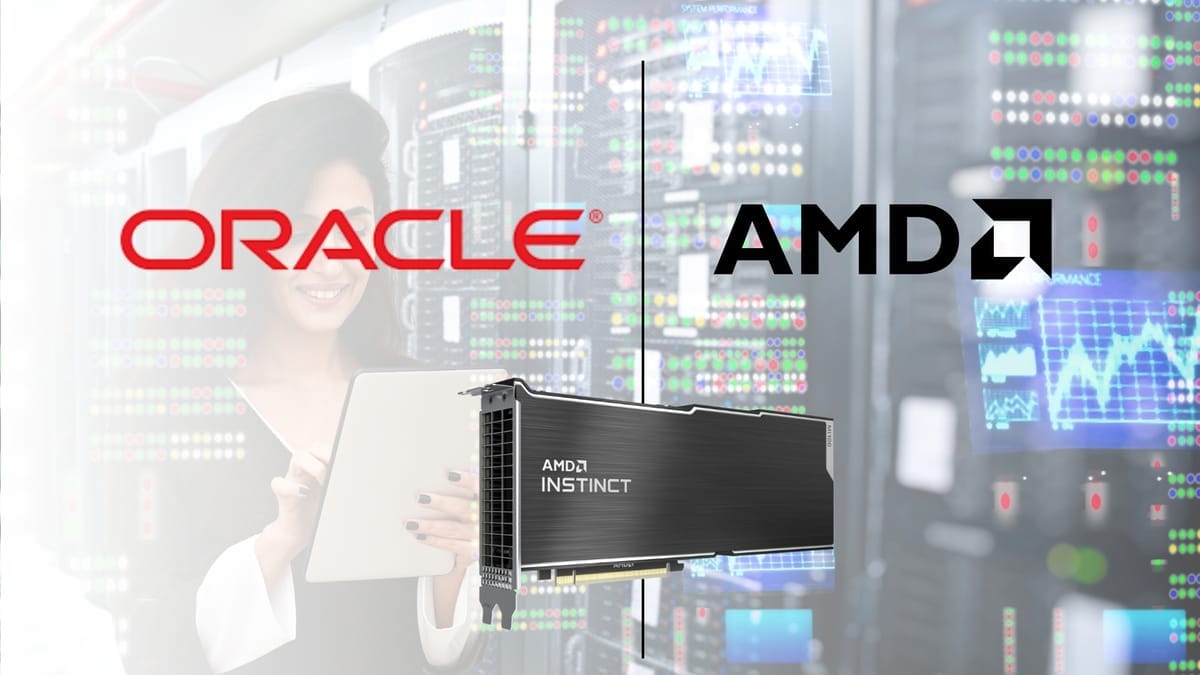
Oracle documenta opciones con NVIDIA GB200, B200, H200, H100, L40S y A100, además de aceleradores AMD Instinct MI300X. Estas familias corresponden a configuraciones distintas y no debe suponerse que todas se ofrecen tanto en VM como en bare metal, o que están disponibles en cualquier región.
 Admin
En una aplicación de IA, las CPU siguen atendiendo tareas como la coordinación de procesos, la lógica de aplicación y el movimiento de datos, mientras las GPU ejecutan el procesamiento acelerado que requiere el modelo. En OCI, la decisión empresarial pasa por seleccionar el tipo de instancia y verificar, por separado, la memoria, la red, el almacenamiento y la capacidad que se podrá contratar.
OCI Supercluster y Zettascale10 no representan la misma escala disponible
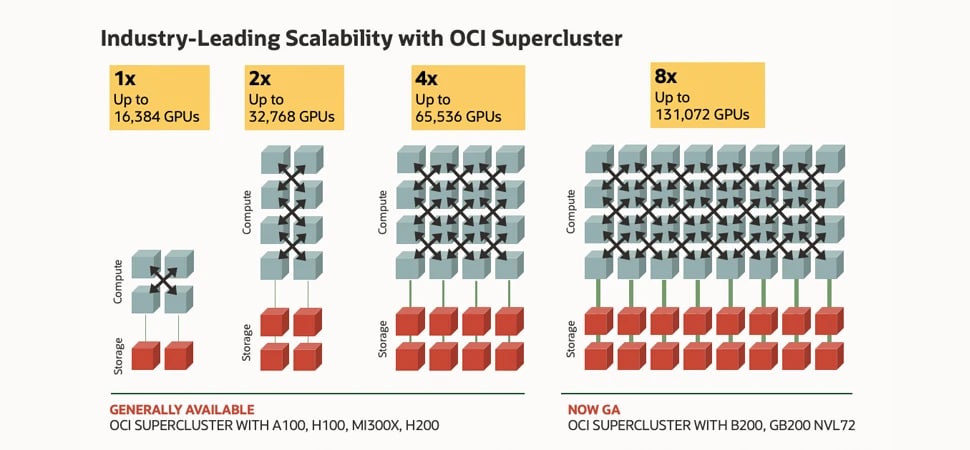
OCI Supercluster combina servidores bare metal con GPU y una red RDMA para trabajos que necesitan intercambiar información entre numerosos nodos. En su descripción de infraestructura para IA, Oracle publica configuraciones escalables hasta 131.072 GPU NVIDIA B200, junto con límites diferentes para otras familias, como 65.536 H200 y 16.384 AMD MI300X.
Son máximos publicados para determinadas arquitecturas, no un inventario que esté necesariamente instalado, libre para contratación o distribuido de manera uniforme entre regiones. La cifra de un Supercluster tampoco informa, por sí sola, cuántos aceleradores puede obtener un cliente para un trabajo concreto.
 Ivan
¿Qué anunció Oracle sobre Zettascale10 en 2025?
El 14 de octubre de 2025, Oracle presentó OCI Zettascale10 como una arquitectura para interconectar GPU en varios centros de datos. La compañía proyectó configuraciones de hasta 800.000 GPU NVIDIA y hasta 16 zettaFLOPS de rendimiento máximo teórico, y señaló entonces que aceptaba pedidos con disponibilidad prevista para el segundo semestre de 2026.
En una publicación del 7 de octubre de 2026, Oracle volvió a mencionar una escala de 800.000 a un millón de GPU para sus mayores Superclusters. Ninguno de esos números permite establecer, sin una confirmación adicional, la cantidad instalada y operativa, el rendimiento medido en una tarea o la capacidad comercial actualmente disponible.
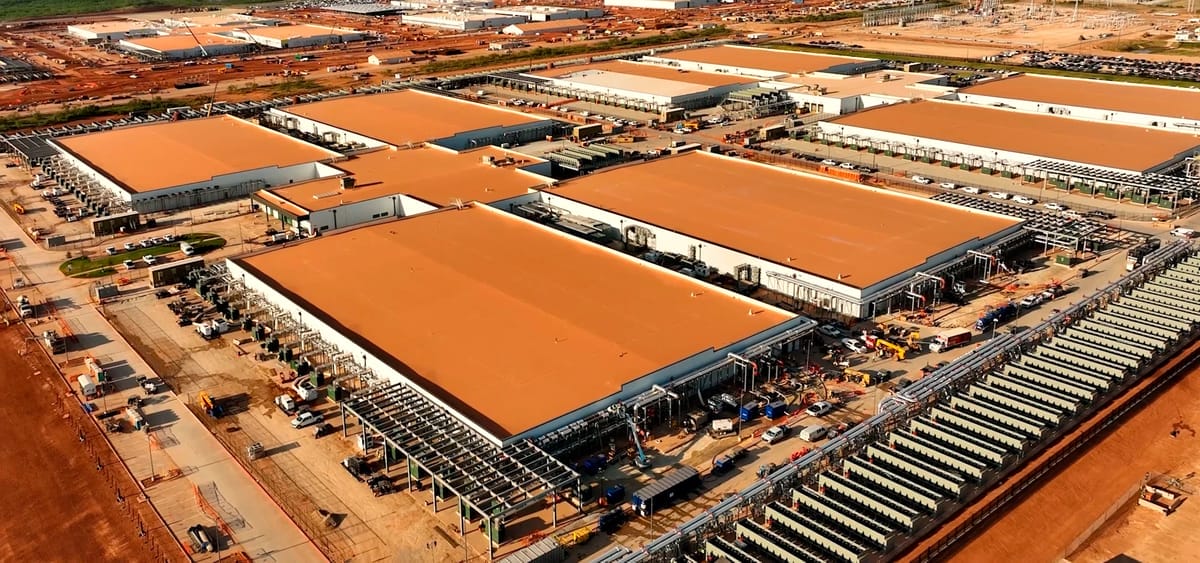
En la presentación de octubre de 2025, Peter Hoeschele, vicepresidente de Infraestructura y Cómputo Industrial de OpenAI, explicó dónde se había desplegado inicialmente la red del sistema y qué buscaba resolver su diseño de interconexión.
“La red y la estructura de interconexión del clúster OCI Zettascale10 se desarrollaron y desplegaron por primera vez en el centro principal de Stargate en Abilene, Texas, nuestro superclúster conjunto con Oracle. El diseño RoCE personalizado y altamente escalable maximiza el rendimiento de toda la red a escala de gigavatios, al tiempo que mantiene la mayor parte de la energía concentrada en el cómputo. Nos entusiasma seguir ampliando Abilene y el programa Stargate en general”.
Esa declaración se refiere al despliegue inicial de la interconexión en Abilene, no a la instalación de las 800.000 GPU del máximo de diseño. La cantidad efectivamente habilitada, su distribución y las condiciones de acceso siguen siendo datos que requieren verificación específica.
 Fabrizio Ballarino
¿Cómo se comunican miles de GPU mediante RDMA y Oracle Acceleron?
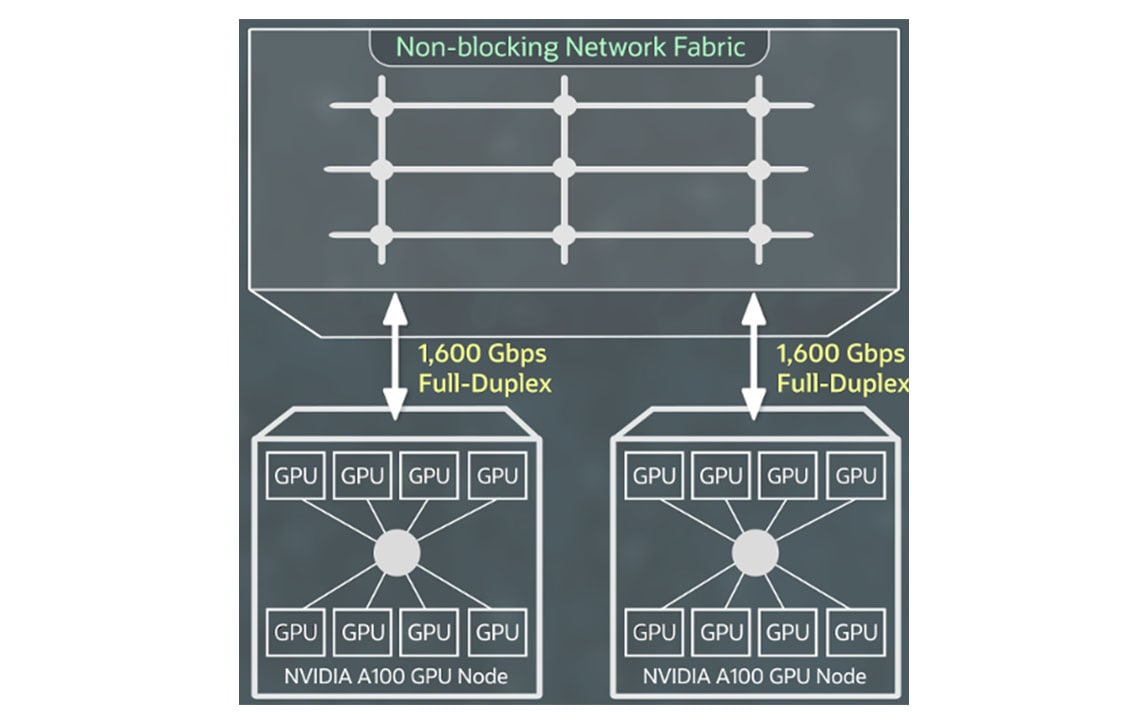
En el entrenamiento distribuido, una parte del tiempo de ejecución puede destinarse al intercambio de información entre servidores. RDMA (Remote Direct Memory Access) permite comunicar la memoria de equipos conectados con menos intervención de sus procesadores, mientras que RoCEv2 lleva ese mecanismo a redes Ethernet utilizadas en los clústeres de OCI.
Oracle publica para determinadas configuraciones de Supercluster latencias de red de 2,5 a 9,1 microsegundos y un ancho de banda de clúster de hasta 3.200 Gb/s. Son especificaciones condicionadas por la arquitectura y el tipo de instancia; no equivalen a la latencia de una aplicación completa ni a una velocidad garantizada entre dos centros de datos cualesquiera.
 Ivan
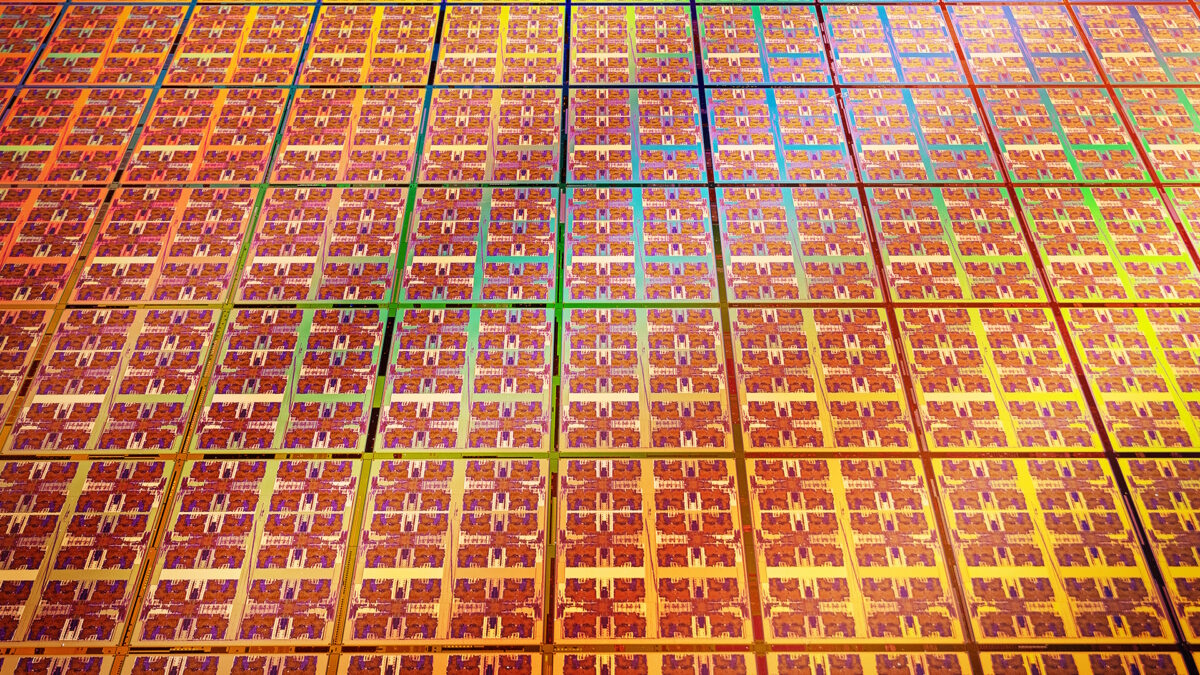
Oracle Acceleron descarga del procesador anfitrión tareas de virtualización de red y almacenamiento, mientras que la arquitectura RoCE de Zettascale10 distribuye enlaces entre planos de red separados para permitir desviar tráfico ante problemas de un plano. Se trata de propiedades del diseño publicadas por Oracle, no de una demostración de que los trabajos nunca se interrumpan.
¿Qué almacenamiento utiliza OCI para datos y puntos de control?
El almacenamiento local NVMe atiende operaciones que requieren acceso rápido desde un servidor. Oracle publica configuraciones GPU con hasta 61,44 TB de capacidad local y las relaciona con la escritura de puntos de control (checkpoints), que permiten conservar estados del entrenamiento para facilitar su recuperación tras una interrupción.
Los volúmenes de Block Storage constituyen otra opción para disponer de almacenamiento asociado a instancias, mientras que Object Storage permite conservar conjuntos de datos y objetos en un servicio separado del disco local. La selección depende de cómo acceden los procesos a los archivos y de si se requiere capacidad local, volúmenes o almacenamiento de objetos.
Para trabajos paralelos, OCI File Storage with Lustre es un sistema de archivos administrado que puede recibir accesos desde numerosos servidores. Oracle documenta niveles de lectura agregada de 125, 250, 500 y 1.000 MB/s por TB aprovisionado; esas cifras suponen condiciones concretas de medición, y la escritura agregada puede alcanzar hasta la mitad del caudal de lectura del nivel respectivo.
 Admin
Que Lustre sea administrado no elimina todas las tareas del cliente: debe instalar clientes compatibles en los servidores, preparar los montajes y optimizar el acceso desde las aplicaciones. Además, este servicio no está presente en todas las regiones de OCI.
Entrenar o servir modelos propios con OCI Kubernetes Engine
Una empresa que despliega sus modelos sobre instancias OCI conserva tareas como preparar el software, administrar los procesos de entrenamiento o inferencia y definir su supervisión. OKE incorpora Kubernetes como plataforma de coordinación de contenedores, pero no convierte por sí mismo una aplicación de IA en un servicio completamente administrado.
Desde agosto de 2026, Oracle documenta tres complementos opcionales en los clústeres OKE mejorados: NVIDIA GPU Operator para componentes del entorno GPU, NVIDIA Network Operator para elementos de red acelerada y Node Feature Discovery para identificar capacidades del hardware y exponerlas al planificador de Kubernetes.
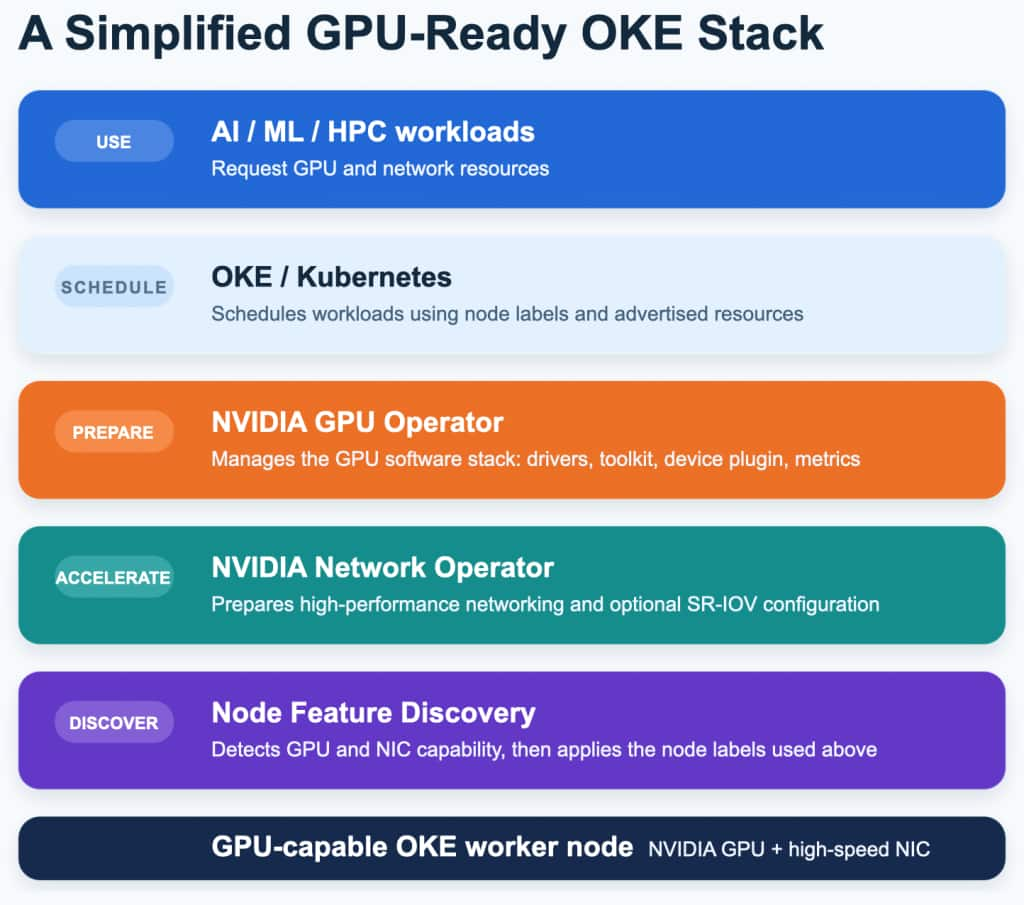
Los complementos vienen desactivados de forma predeterminada y su uso exige comprobar la compatibilidad entre versión de Kubernetes, imágenes de los nodos, controladores, GPU y adaptadores de red. En equipos compatibles, el operador de GPU puede administrar componentes para particionar recursos mediante NVIDIA Multi-Instance GPU (MIG), mientras que el operador de red contempla configuraciones RDMA y GPUDirect RDMA.
 Admin
OCI Generative AI permite elegir entre inferencia bajo demanda y capacidad dedicada
Con OCI Generative AI, el cliente puede utilizar modelos compatibles a través de una modalidad bajo demanda, sin tener que crear previamente un clúster de GPU dedicado. Oracle señala que cada llamada de inferencia se cobra según el uso y que esta opción sirve para pruebas, evaluación y otras aplicaciones, siempre que el modelo esté admitido en la región elegida.
La modalidad bajo demanda tiene una restricción operativa importante: Oracle ajusta dinámicamente los límites de solicitudes según la demanda y la capacidad del sistema, por lo que esos límites pueden cambiar. La documentación recomienda introducir esperas progresivas ante rechazos, en lugar de repetir peticiones de inmediato.
En el modo dedicado, el servicio asigna capacidad GPU para alojar y ajustar modelos admitidos, y se accede al modelo por medio de un punto de conexión asociado al clúster. Para alojar modelos preentrenados o ajustados de OCI Generative AI, Oracle documenta un compromiso mínimo de 744 horas-unidad por clúster de alojamiento; los modelos importados compatibles tienen una excepción a ese compromiso, y los trabajos de ajuste siguen otras condiciones mínimas.
Por lo tanto, contratar una instancia GPU, desplegar un servicio en OKE y consumir un modelo de OCI Generative AI son decisiones diferentes. La primera entrega infraestructura de cómputo, la segunda incorpora coordinación de contenedores y la tercera abstrae una parte de la operación del modelo bajo condiciones propias de consumo y capacidad.
 Admin
OCI Enterprise AI y los Accelerator Packs agregan otra capa de gestión
OCI Enterprise AI reúne acceso a modelos, herramientas para agentes y controles de gobierno dentro de un servicio orientado a aplicaciones empresariales. Oracle comunicó su disponibilidad general en marzo de 2026 en un grupo definido de regiones, entre ellas São Paulo, Frankfurt, Londres, Ashburn y Phoenix, sin que eso implique presencia en todas las ubicaciones de OCI.
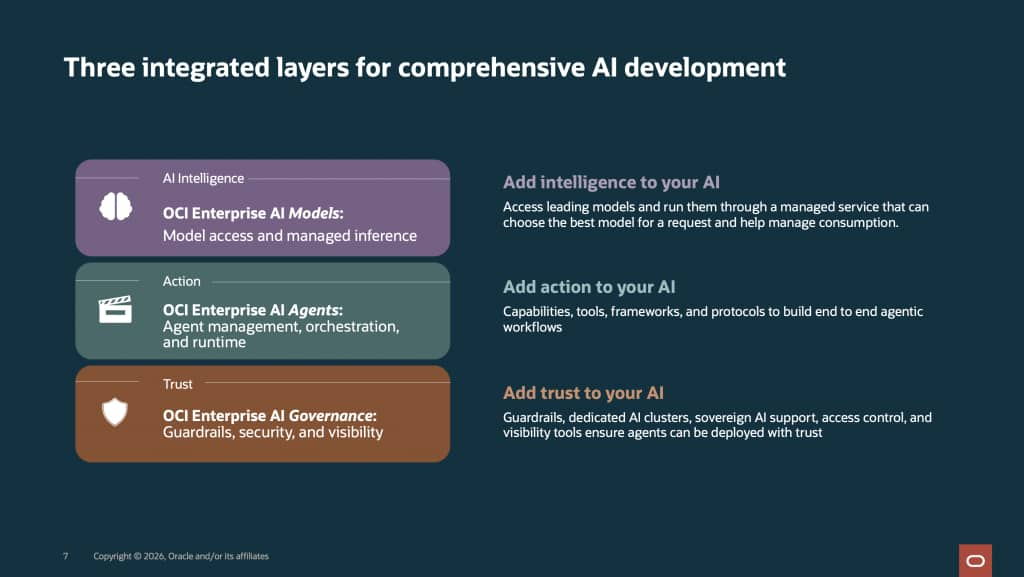
La plataforma contempla alojamiento administrado de agentes y compatibilidad con el formato de solicitudes de la OpenAI Responses API, además de funciones para coordinar agentes y establecer controles de acceso. Su alcance es diferente al de un Supercluster, porque presenta recursos de modelos y aplicaciones, mientras el servicio de infraestructura concentra las decisiones sobre servidores, interconexión y almacenamiento.
 Admin
Por su parte, los OCI AI Accelerator Packs son conjuntos preconfigurados para casos de uso como asistentes basados en conocimiento empresarial, análisis de video y aplicaciones agénticas. Oracle indica que combinan infraestructura, servicios, componentes de software y mecanismos de evaluación que se despliegan en el entorno del cliente; el tipo de modelo y la modalidad administrada o propia dependen del paquete escogido.
¿Qué controles de seguridad debe preparar la organización?
La infraestructura de OCI dispone de herramientas para administrar permisos, claves y supervisión, pero corresponde a cada organización configurar su alcance. Identity and Access Management (IAM) define qué usuarios o grupos pueden actuar sobre determinados recursos; los compartments ayudan a separar proyectos y aplicar políticas de autorización y seguimiento del consumo.
Para las claves de cifrado, OCI Key Management y sus bóvedas permiten centralizar la administración y contemplan modalidades de mayor aislamiento o claves externas. La documentación actual distingue la gestión de secretos en un servicio específico, por lo que no conviene tratar las claves criptográficas y las credenciales de aplicaciones como si fueran exactamente el mismo recurso.
Cloud Guard revisa configuraciones y actividades que pueden representar riesgos y, de acuerdo con las reglas definidas, propone o ejecuta respuestas. La existencia de estas funciones no significa que cada control esté activado automáticamente ni sustituye la necesidad de definir permisos, revisiones y procedimientos de respuesta.
 Francisco Carrasco M.
¿Cómo observar la operación y comprobar la capacidad disponible?
OCI Monitoring recopila métricas y permite configurar alarmas según valores definidos, mientras que OCI Logging reúne registros de auditoría, de servicios compatibles y de aplicaciones que envían sus propios eventos. Para cargas sobre OKE, los componentes de NVIDIA pueden exponer información de las GPU, pero su instalación y configuración también forman parte del trabajo operativo.
La capacidad de cómputo exige dos comprobaciones distintas. Una empresa puede tener cuotas suficientes para solicitar un tipo de GPU y, aun así, recibir un error por falta de servidores disponibles en una región; la documentación de Oracle identifica por separado los límites de servicio y el mensaje Out of host capacity.
Las reservas de capacidad permiten asignar anticipadamente determinadas instancias en un dominio de disponibilidad y una cuenta OCI, pero dependen de que exista capacidad al momento de reservar. No pueden trasladarse entre dominios de disponibilidad ni entre cuentas, y la capacidad reservada que permanece sin uso genera cargos.
Por eso, la disponibilidad debe revisarse para la combinación concreta de región, modelo de GPU, tipo de instancia, cuota, reserva y servicio administrado. Las características publicadas para un centro de datos o una familia de productos no demuestran que toda la configuración pueda contratarse de inmediato en otro lugar.
 Admin
¿Qué información queda por confirmar durante Oracle AI World 2026?
El programa de Oracle sitúa la sesión de Mahesh Thiagarajan, presidente de Oracle Cloud Infrastructure, el martes 27 de octubre a las 10:30, hora de Las Vegas. NVIDIA anuncia para ese mismo día, entre las 13:00 y las 13:45, una sesión sobre la infraestructura para inferencia y sus métricas de eficiencia, y tiene en el programa, aún sin horario, una presentación dedicada a clústeres de hasta 800.000 GPU.
Hasta que esas exposiciones y sus documentos técnicos se publiquen, corresponde distinguir la arquitectura presentada anteriormente de cualquier novedad sobre despliegues, configuraciones, regiones, resultados medidos o contratación. Esos datos permitirán precisar la capacidad operativa de OCI sin convertir sus máximos de diseño en disponibilidad comprobada.
 Admin