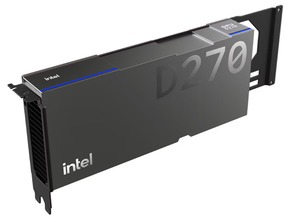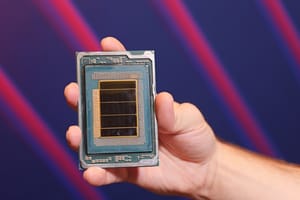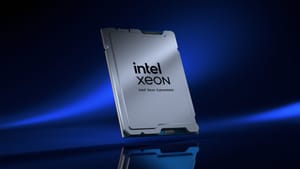
Intel anunció soporte desde el lanzamiento para Muse Spark Open, el modelo de pesos abiertos de Meta con 816 mil millones de parámetros, en procesadores Xeon y sus próximas GPU D-series para centros de datos.
Orientado a programación con IA agéntica, el modelo combina generación y depuración de código con comprensión de repositorios. Su ventana de contexto de un millón de tokens permite abordar proyectos completos con dependencias complejas, código heredado y miles de archivos.
Muse Spark Open también interpreta audio, video, imágenes y documentos para generar texto. Fue entrenado para planificar, actuar, observar y corregirse en tareas prolongadas, navegar por la web, coordinar subagentes y utilizar equipos de escritorio, dispositivos móviles y navegadores.
 Admin
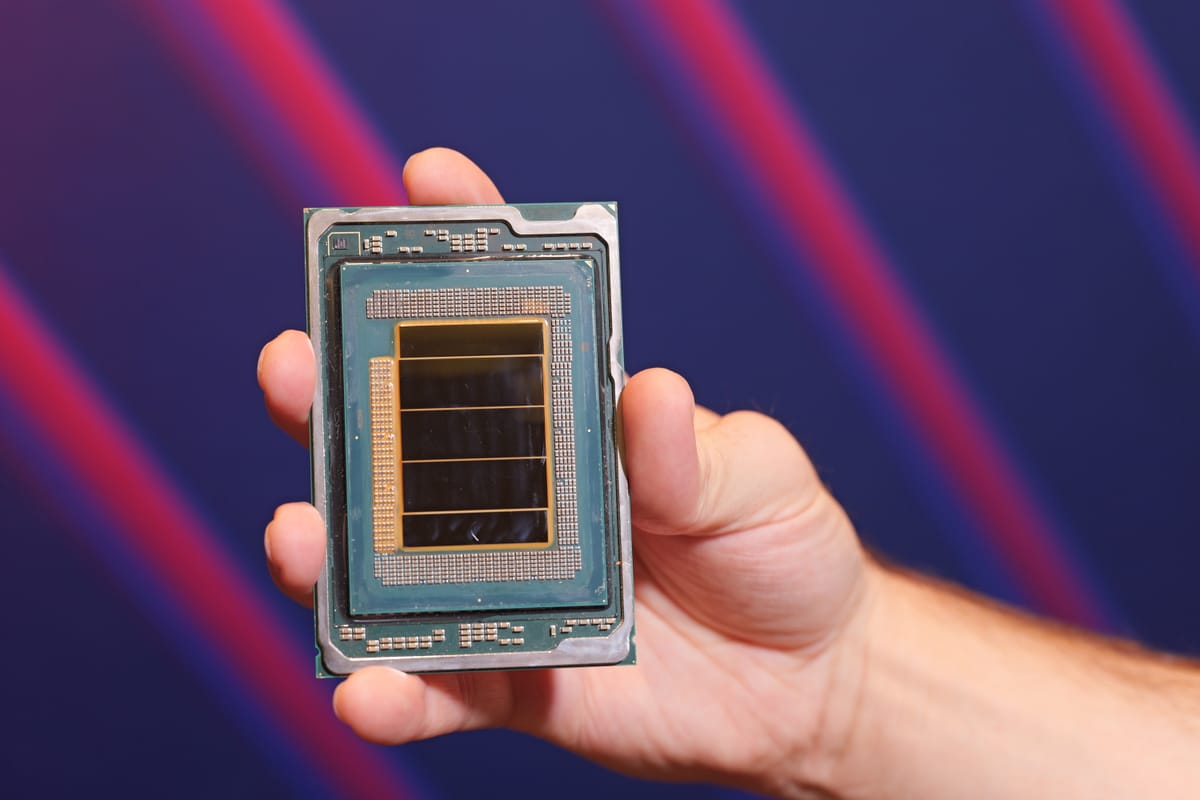
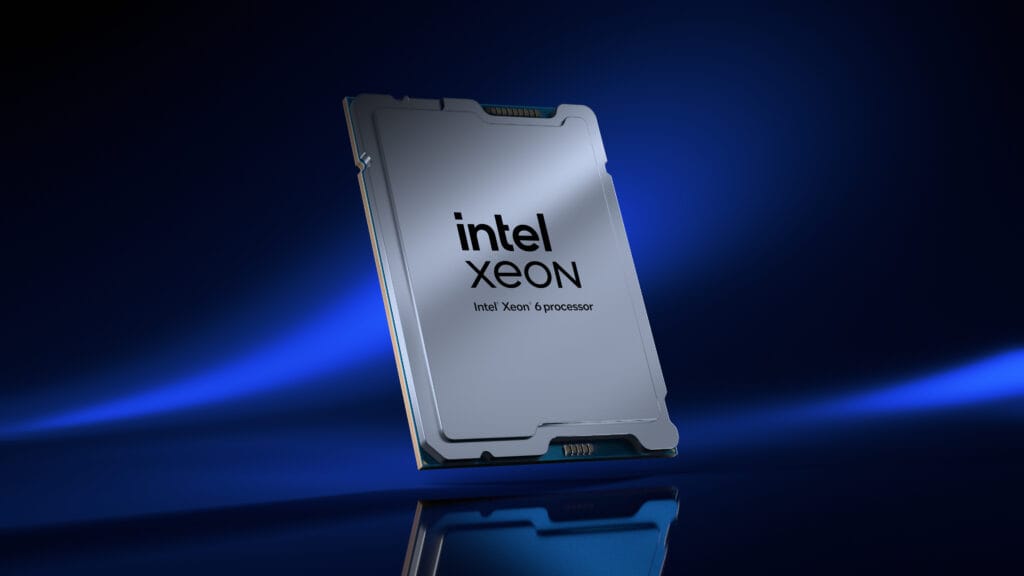
En procesadores Xeon, la implementación utiliza cuantización INT4 aplicada únicamente a los pesos del modelo, denominada WOQ, para reducir la memoria requerida. Las extensiones Intel AMX aportan aceleración de las operaciones matriciales de inteligencia artificial.
La compañía presentó esta alternativa para inferencia sin conexión, aprovechando la capacidad de memoria del sistema. El enfoque permite ejecutar las cargas de forma privada y replicar los despliegues sobre infraestructura Xeon existente en los centros de datos.
Pruebas en cuatro GPU D-series y especificaciones de la plataforma
Intel informó que ya probó el modelo en una configuración de cuatro GPU D-series con 160 GB de memoria por unidad. Según la compañía, ese conjunto ofrece capacidad suficiente para ejecutar Muse Spark Open en racks convencionales refrigerados por aire.
 Admin
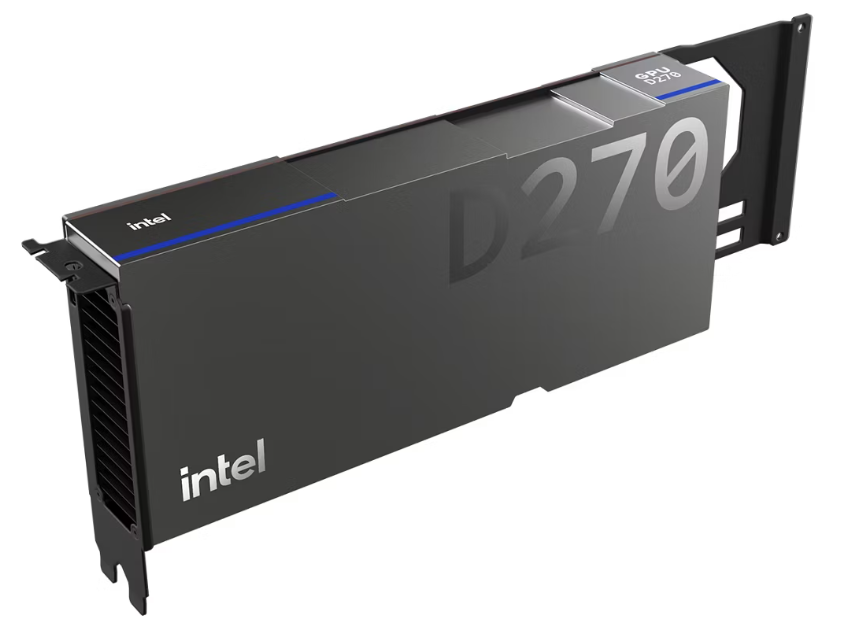
Las GPU emplean la arquitectura Xe3P e incorporan 32 núcleos Xe3P y 256 motores Intel XMX, además de aceleración por hardware para distintos tipos de datos, incluido MXFP4, utilizado en la versión cuantizada destinada a esta plataforma.
La familia contempla memoria LPDDR5x de 160 GB y opciones de hasta 480 GB, con un formato de tarjeta PCIe de 350 W y refrigeración por aire que Intel plantea como una forma de simplificar el despliegue.
Cuantización desde BF16 e integración en vLLM y SGLang
Para preparar ambas implementaciones, Intel generó variantes MXFP4 e INT4 directamente desde los pesos originales BF16 de Muse Spark Open. El proceso utilizó llm-compressor, la herramienta de cuantización nativa de vLLM, con el algoritmo AutoRound.
AutoRound ajusta por capas los parámetros de redondeo y los rangos de recorte con el objetivo, según Intel, de conservar las capacidades de razonamiento del modelo al reducir la precisión numérica para ejecutar una arquitectura de esta escala.
 Admin
Los pesos MXFP4 se distribuyen en formato compressed-tensors para aprovechar la aceleración nativa de las GPU D-series, mientras que los pesos INT4 emplean GPTQ para ejecutar inferencia WOQ en Xeon, con el objetivo de reducir memoria y latencia.
El soporte integrado en la versión principal de vLLM para compressed-tensors, incluido MXFP4, y GPTQ permite ejecución matricial acelerada, procesamiento continuo por lotes y PagedAttention en despliegues de varios nodos, como parte de la estrategia de Intel de incorporar mejoras en los proyectos originales.
En SGLang, la integración nativa de ejecución microscaling, o MX, y los kernels optimizados para Intel XPU se orienta al procesamiento continuo por lotes y a inferencia de baja precisión para flujos de IA agéntica de varios turnos.
 Admin
Las instrucciones para ejecutar el modelo en Xeon con SGLang están disponibles en el recetario de ese proyecto. Intel también señaló que trabaja con la comunidad de vLLM para incorporar instrucciones específicas de implementación sobre sus procesadores.