Intel probó una arquitectura de inferencia para generación de video por difusión que ejecuta por separado la creación de representaciones latentes y su conversión a píxeles sobre GPU Intel Arc Pro B70. La compañía reportó hasta un 28% más de rendimiento medido frente a su mejor configuración agregada utilizando la misma cantidad de GPU.
 Admin
La desagregación pasa de los tokens a los cuadros de video
La propuesta aplica a la generación de video un principio utilizado anteriormente en inferencia de modelos de lenguaje, donde etapas con distintas exigencias de cómputo y memoria pueden separarse para asignarles recursos de manera independiente. En este caso, Intel divide el trabajo entre el Diffusion Transformer o DiT, encargado de generar las representaciones latentes del video, y el VAE, que convierte esa información en cuadros RGB.
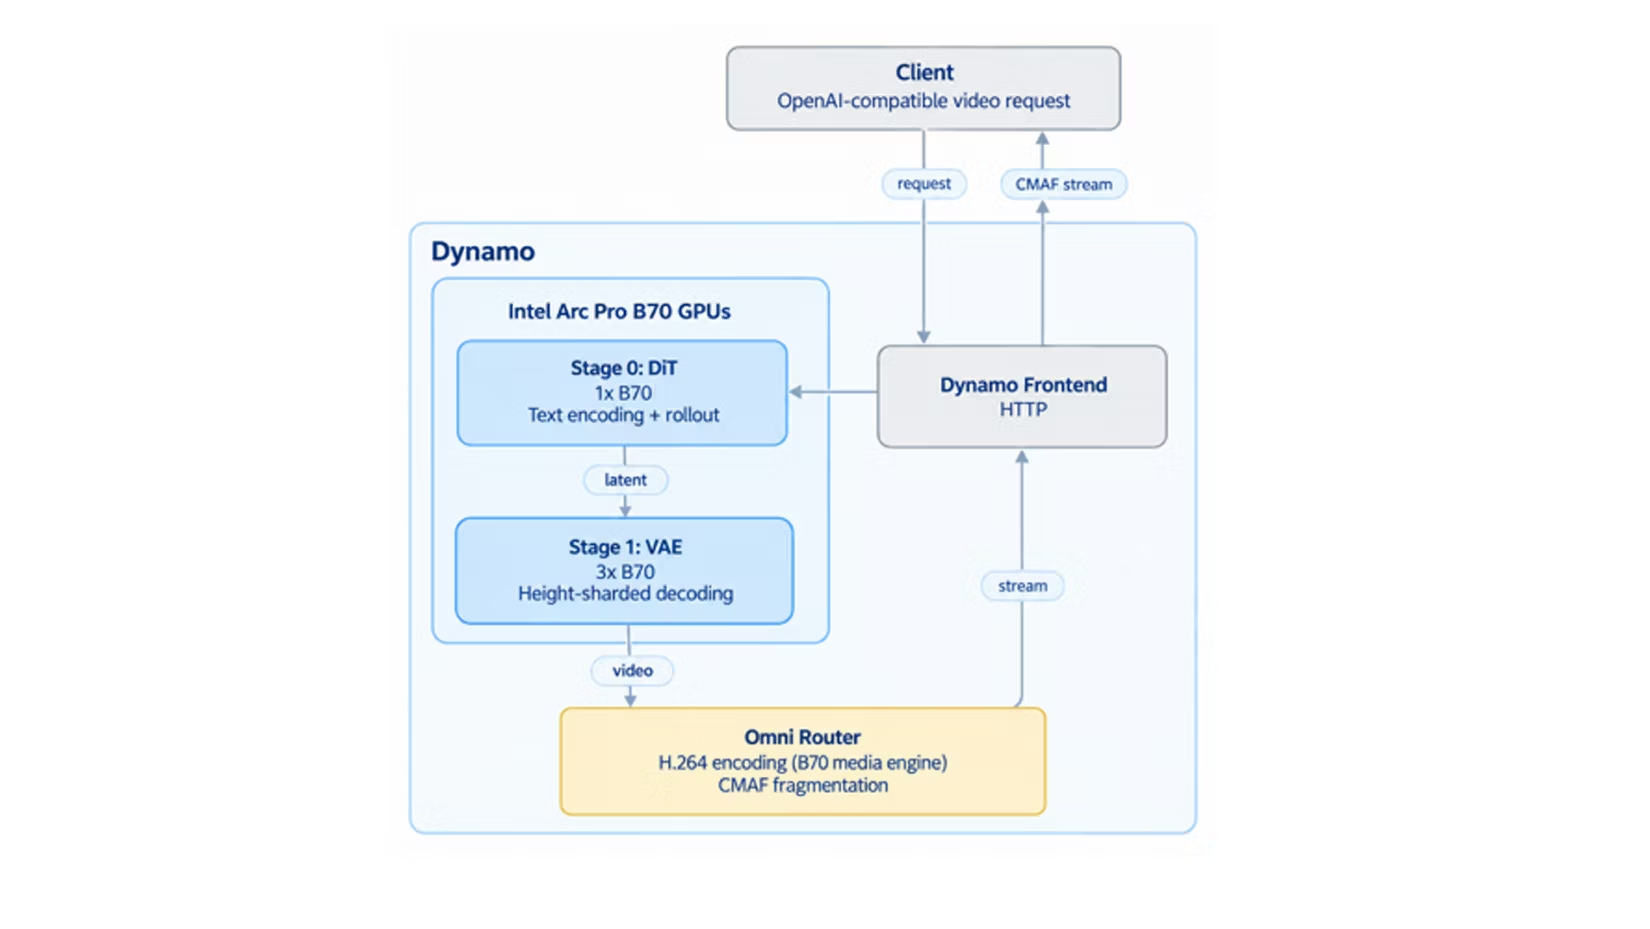
La codificación de texto permanece junto al DiT, mientras que la compresión H.264 utiliza el motor multimedia de una de las GPU Arc Pro B70 ya presentes en la configuración. La separación no distribuye sucesivos pasos de eliminación de ruido entre GPU distintas, sino que establece el límite entre la generación latente y la decodificación de píxeles.
 Admin
La decodificación VAE concentra el cuello de botella
La implementación utiliza Causal Forcing Wan 2.1, que modifica el proceso convencional de difusión para producir bloques latentes de forma incremental y permitir su decodificación a medida que se generan. Intel señala que su modelo destilado ejecuta un paso DiT por cada bloque latente y posteriormente el VAE lo transforma de inmediato en cuadros RGB.
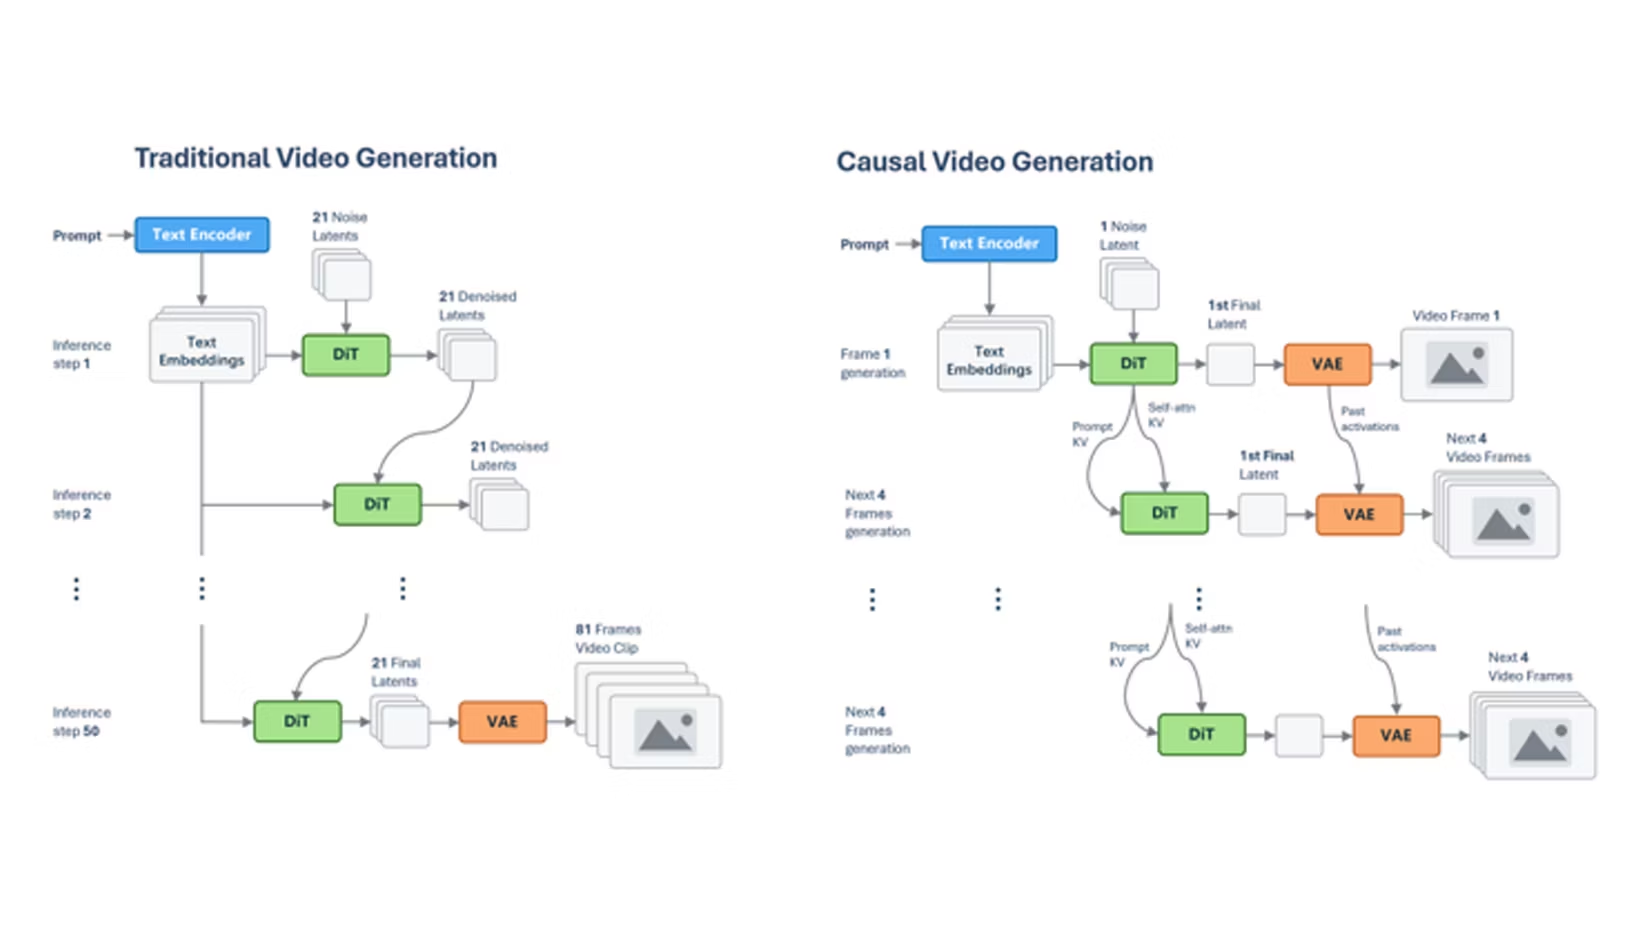
Las mediciones de Intel identificaron a la decodificación VAE como la etapa más lenta de este flujo, por lo que la compañía distribuyó espacialmente el trabajo entre GPU adicionales mientras mantuvo el DiT en un grupo más pequeño de aceleradores. Esta división también separa los presupuestos de memoria y permite que el DiT genere el siguiente bloque latente mientras el VAE procesa el anterior.
En la configuración publicada, el DiT por sí solo utiliza aproximadamente 25,9 GB de los 32 GB disponibles en una Arc Pro B70. Ejecutar el VAE por separado deja mayor margen para caché, búferes de codificación y otras asignaciones necesarias durante la ejecución.
 Admin
Hasta 28% más throughput con la misma cantidad de GPU
Intel comparó configuraciones agregadas y desagregadas manteniendo constante el número total de GPU Arc Pro B70, con una carga de Causal Forcing Wan 2.1-1.3B T2V de tres escenas y 243 cuadros a una resolución de 832 × 480 píxeles. El entorno utilizó Dynamo con vLLM-Omni y codificación H.264 mediante VA-API sobre el motor multimedia de la propia GPU.
Con dos GPU, la configuración desagregada obtuvo un 14% más de rendimiento medido que la mejor alternativa agregada evaluada por Intel. Al utilizar cuatro GPU, la diferencia aumentó hasta el 28%, con una Arc Pro B70 destinada al DiT y tres asignadas a la decodificación VAE.
La diferencia no proviene de agregar aceleradores, sino de distribuir las GPU disponibles según las características de cada etapa del procesamiento. La arquitectura reduce la competencia por recursos entre DiT y VAE y permite dedicar una mayor parte de la capacidad disponible al proceso de decodificación que presenta el mayor cuello de botella.
 Admin
Dynamo y vLLM-Omni coordinan el servicio de video
La implementación combina el modelo Causal Forcing Wan con vLLM-Omni y Dynamo, además de incorporar codificación de video por hardware y soporte de transmisión mediante Common Media Application Format o CMAF. El frontend de Dynamo recibe las solicitudes HTTP y entrega fragmentos de video a medida que son producidos, mientras los trabajadores DiT y VAE procesan las etapas correspondientes.
Intel también advierte que el aumento de throughput medido no equivale directamente a una reducción del costo total de propiedad. Una evaluación de TCO requiere incorporar consumo eléctrico, sistemas anfitriones, infraestructura, utilización y métricas de calidad del servicio, variables que no forman parte de esta comparación.