NVIDIA publicó los primeros resultados preliminares de Vera Rubin NVL72 en MLPerf Inference v6.1, con pruebas sobre los modelos Qwen3-VL y DeepSeek-R1. La compañía comparó su nueva arquitectura con GB300 NVL72 y también presentó resultados obtenidos por Blackwell Ultra en distintas cargas de inferencia.
Vera Rubin NVL72 entra a las pruebas de MLPerf Inference
Las pruebas con Qwen3-VL utilizaron vLLM y NVIDIA Dynamo, mientras que DeepSeek-R1 fue ejecutado mediante TensorRT-LLM. NVIDIA también empleó inferencia desagregada para separar las etapas de prefill y decode, además de paralelismo de expertos en modelos mixture-of-experts.
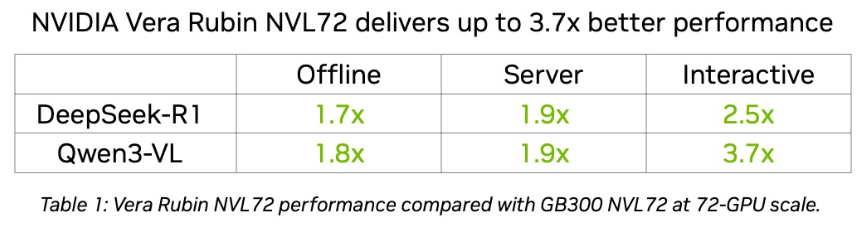
Los principales resultados informados por NVIDIA fueron:
- Vera Rubin NVL72 alcanzó hasta 3,7 veces más throughput que GB300 NVL72 en Qwen3-VL.
- En DeepSeek-R1 registró hasta 2,5 veces más throughput frente a GB300 NVL72.
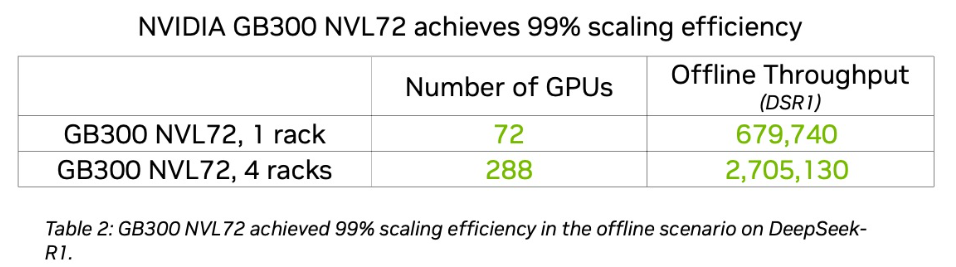
- GB300 NVL72 alcanzó 99% de eficiencia de escalamiento al pasar de un rack con 72 GPU a cuatro racks con 288 GPU en DeepSeek-R1.
- En WAN 2.2, GB300 NVL72 alcanzó 0,65 videos 720p por segundo.
- La latencia en WAN 2.2 llegó a 5,7 segundos por video.
- Frente a un solo nodo, ese resultado representa nueve veces más throughput y una latencia 7,5 veces menor.
- Las optimizaciones de software elevaron hasta 1,6 veces el rendimiento de GB300 NVL72 en Qwen3-VL frente a MLPerf Inference v6.0.
- NVIDIA también publicó resultados posteriores al cierre de MLPerf Inference v6.1 para GPT-OSS-120B y DLRMv3, los cuales todavía no habían sido verificados por MLCommons al momento del anuncio.
Vera Rubin NVL72 incorpora NVLink de sexta generación y NVLink Switch, además de soporte para precisión NVFP4 en pesos, atención y caché KV. NVIDIA señala que estas características forman parte de las mejoras utilizadas para aumentar el rendimiento de inferencia y reducir el movimiento de datos dentro del sistema.
NVIDIA también entregó resultados de escalamiento para GB300 NVL72, donde mostró cómo varía el throughput al ampliar la configuración desde un rack hasta cuatro racks