OpenAI presentó LifeVal, una evaluación del desempeño de sus modelos de inteligencia artificial en gestiones de la vida diaria que requieren más que una respuesta conversacional. Las pruebas abarcan cuidados familiares, educación, administración del hogar, finanzas personales, compras y acceso a servicios públicos.
La selección de actividades partió de los estudios American Time Use Survey de Estados Unidos y Multinational Time Use Study, complementados con una encuesta demográficamente representativa a 3995 personas para identificar dónde se valoraría más la ayuda de asistentes personales de IA.
 Admin
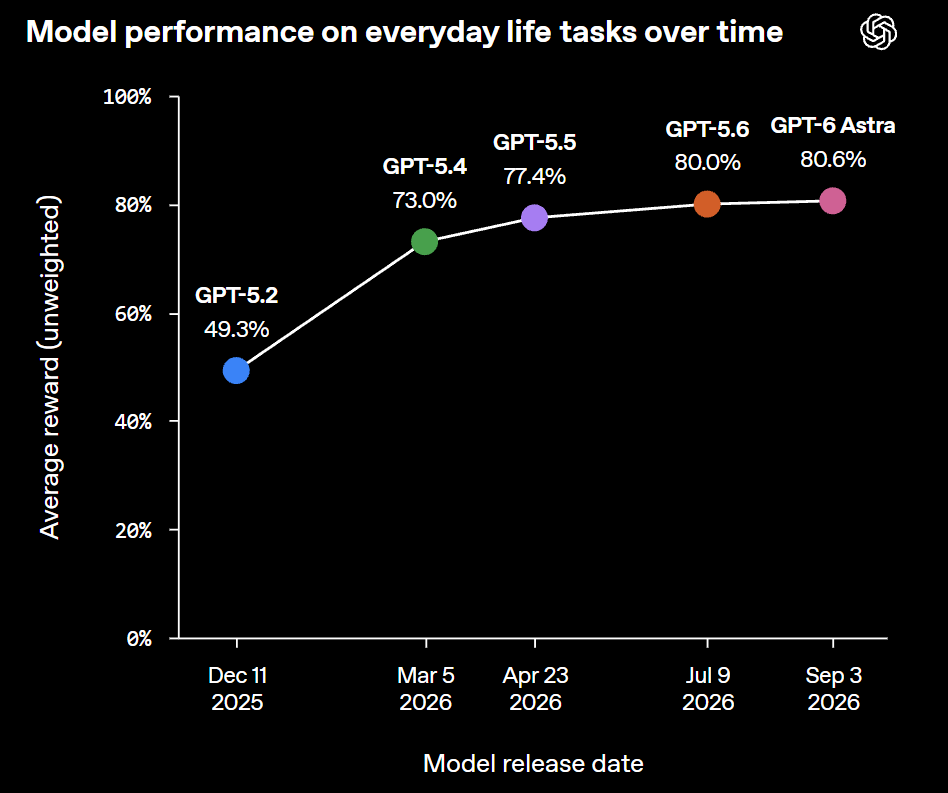
Los resultados de los modelos pasan de 49.3% a 80.6%
La primera comparación muestra el avance en la recompensa promedio no ponderada, que es la métrica utilizada en el gráfico de LifeVal. GPT-5.2 obtuvo 49.3% en diciembre de 2025, mientras que GPT-5.4 alcanzó 73.0% en marzo de 2026 y GPT-5.5 registró 77.4% en abril.
 Admin
La progresión continuó con 80.0% para GPT-5.6 en julio y 80.6% para GPT-6 Astra en septiembre de 2026. Así, la diferencia entre los dos modelos más recientes de la comparación fue de 0.6 puntos porcentuales, considerablemente menor que la registrada entre GPT-5.2 y GPT-5.4.
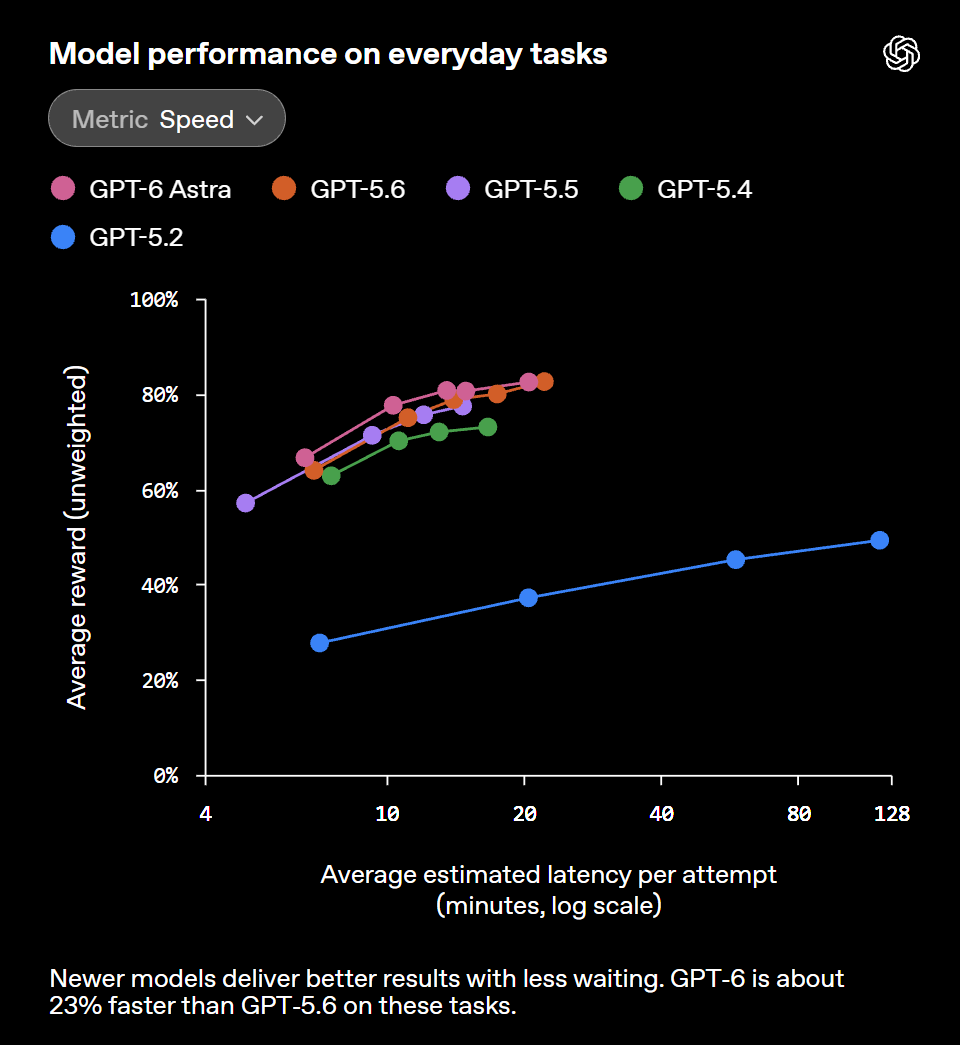
OpenAI compara los resultados con la latencia por intento
El segundo gráfico relaciona la recompensa media con la latencia estimada por intento, medida en minutos y representada en escala logarítmica. Según OpenAI, GPT-6 es aproximadamente 23% más rápido que GPT-5.6 en las tareas de LifeVal.
 Admin
Durante el último año, la empresa entrenó sus modelos para mejorar su desempeño en el uso de navegadores, computadores y conectores de servicios, capacidades que permiten ampliar el tipo de tareas que puede abordar ChatGPT.
Entre los ejemplos publicados figuran la selección de jardines infantiles tras una mudanza, con una puntuación de 93.1%, y la coordinación de voluntarios ante una inundación, con 98.0%. La búsqueda de una vivienda aparece con 100%, mientras que la preparación de un plan de comidas para una persona recientemente diagnosticada con diabetes registra 90.4%.